简体中文
 English

ROCm 是什么?AMD 挑战英伟达 CUDA 的武器到底行不行?
本文目录
ROCm 是什么?
ROCm 的全称是 Radeon Open Compute,是 AMD 面向 GPU 通用计算的软件栈。它和 CUDA 处在同一层:向上承接 PyTorch、TensorFlow 这类深度学习框架,向下调度显卡的算力。开发者写模型时用的是框架,但框架最终要靠这一层把计算任务翻译成显卡能执行的指令。
两者的根本差别在于开放程度。CUDA 是英伟达的闭源生态,只能运行在英伟达硬件上;ROCm 是开源的,理论上可移植性更强。这个差别在商业上的意义很直接:客户如果要换硬件供应商,迁移成本的高低就取决于这一层的兼容性。
也正因如此,评价 AMD 在 AI 芯片上的竞争力,不能只看它的显存容量和算力参数。硬件是可以快速追赶的,软件生态需要时间——这是这个行业里最不对称的一件事。
ROCm 和 CUDA 差在哪?
差距在收窄,但没有消失。按公开测试汇总,在 MI300X 世代(2024 年前后),ROCm 的推理吞吐大约只有对标英伟达产品的 37% 至 66%;到 2026 年,这个差距收窄到约 10% 至 25%。也就是说,同级硬件上 ROCm 目前能跑到 CUDA 的七成半到九成。
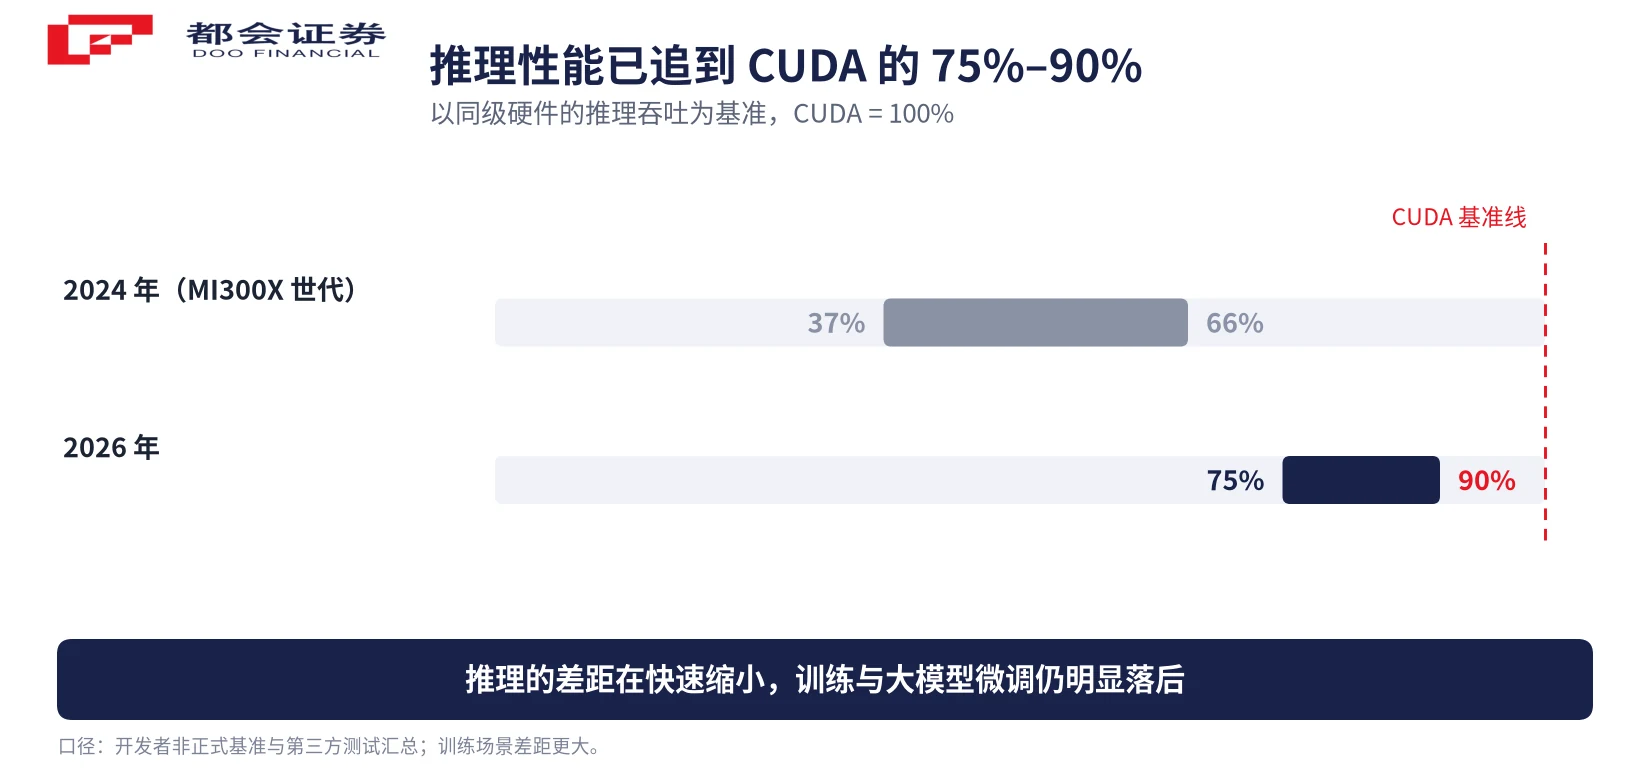
但推理不等于训练。在大规模训练与模型微调上,差距更明显:CUDA 的多卡通信库、FP8 训练配方、算子优化工具经过多年打磨,整体更顺;ROCm 对应的组件在补齐,但成熟度仍有距离。一些 CUDA 独占的库——例如 TensorRT-LLM 与 FlashAttention 3——在 ROCm 上还没有完整等价物,围绕它们构建的工作负载迁移时会付出实际的工程成本。
| 对比维度 | CUDA | ROCm |
|---|---|---|
| 推出时间 | 2006 年 | 晚约十年 |
| 开源 | 闭源 | 开源 |
| 框架支持 | 事实上的默认后端 | PyTorch、JAX 原生支持 |
| 多卡通信 | NCCL | RCCL |
| 算子与推理库 | cuDNN、TensorRT-LLM 等 | MIOpen、vLLM 支持 |
| 推理性能(同级硬件) | 基准 | 约为基准的 75%–90% |
| 训练与微调 | 工具链成熟 | 差距更大 |
以上为公开测试与开发者反馈的汇总口径,具体差距随工作负载类型变化很大。
客户为什么开始用 AMD?
答案不在软件,而在采购逻辑。对超大规模客户来说,选择 AMD 的理由通常是三条:价格、供应与议价空间。
价格上的差距是明面上的。AMD 的加速卡价格较同级英伟达方案低 15% 至 40%,对动辄数万张卡、总额以百亿美元计的集群采购来说,这个差值是实打实的。供应上,先进封装产能长期紧张,多一个可交付的供应商就多一份确定性。而议价空间这层更微妙:拥有第二个选项本身,就是与主供应商谈判时的筹码。
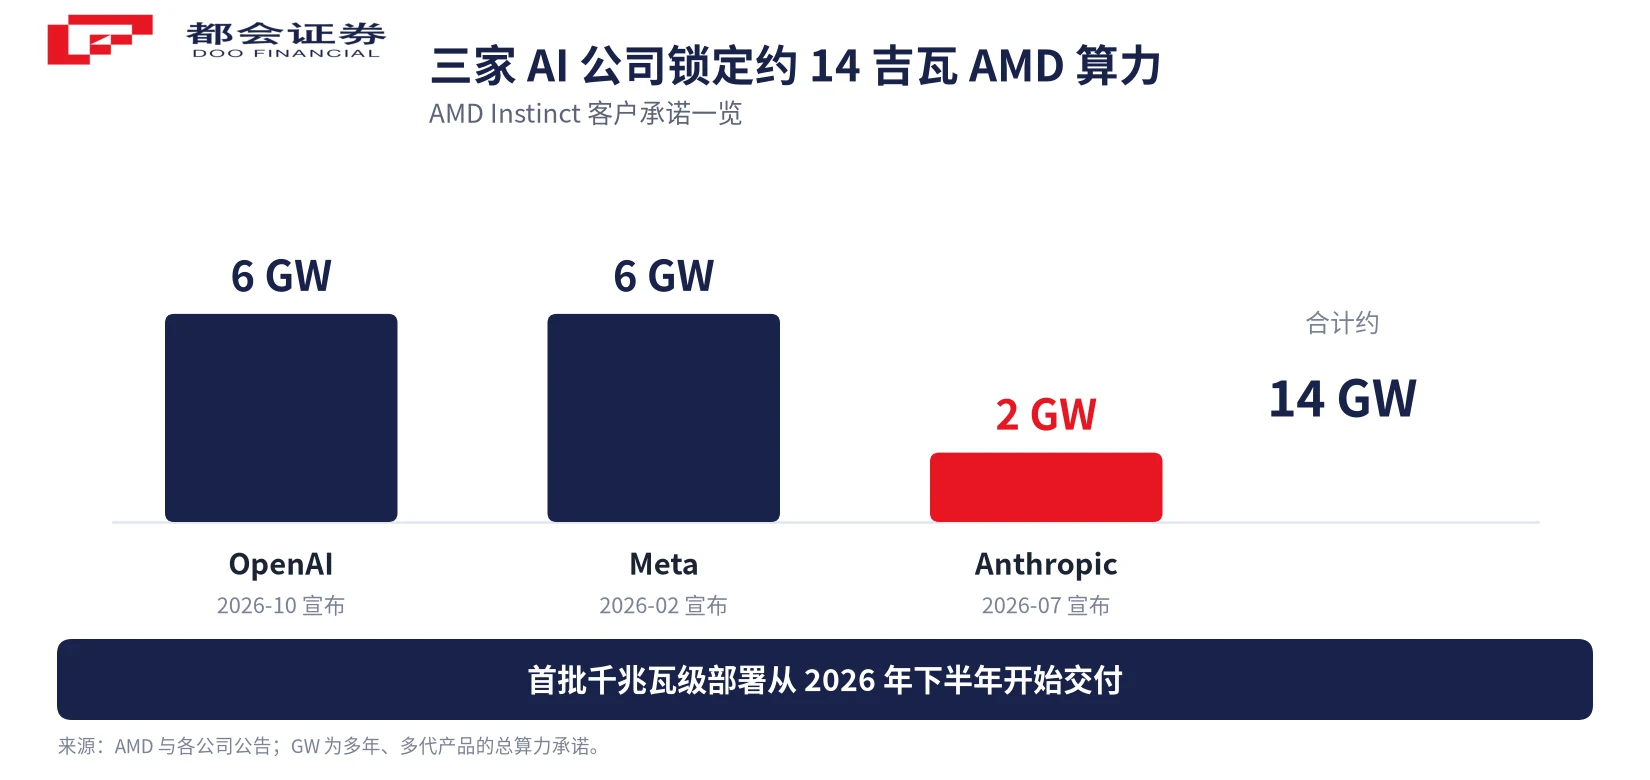
2025 年 10 月,AMD 与 OpenAI 达成多年、多代产品的合作协议,总算力规模约 6 吉瓦,首批 1 吉瓦计划于 2026 年下半年部署。2026 年 2 月,Meta 签下同样约 6 吉瓦的协议,包含基于 MI450 的定制芯片与共同开发的机柜架构,首 1 吉瓦在 2026 年下半年出货。2026 年 7 月,Anthropic 加入,规模最多 2 吉瓦,首批 1 吉瓦预计 2027 年上半年交付。三家合计约 14 吉瓦。
这些协议的关键含义在于:它们不是测试性采购,而是要在生产环境里跑真实业务。Meta 的基础设施团队不会轻易承担软件栈风险——这份承诺本身就是对 ROCm 可用性的背书。
ROCm 现在发展到哪一步了?
从「能不能用」到「好不好用」,ROCm 在过去两年跨过了第一道门槛。
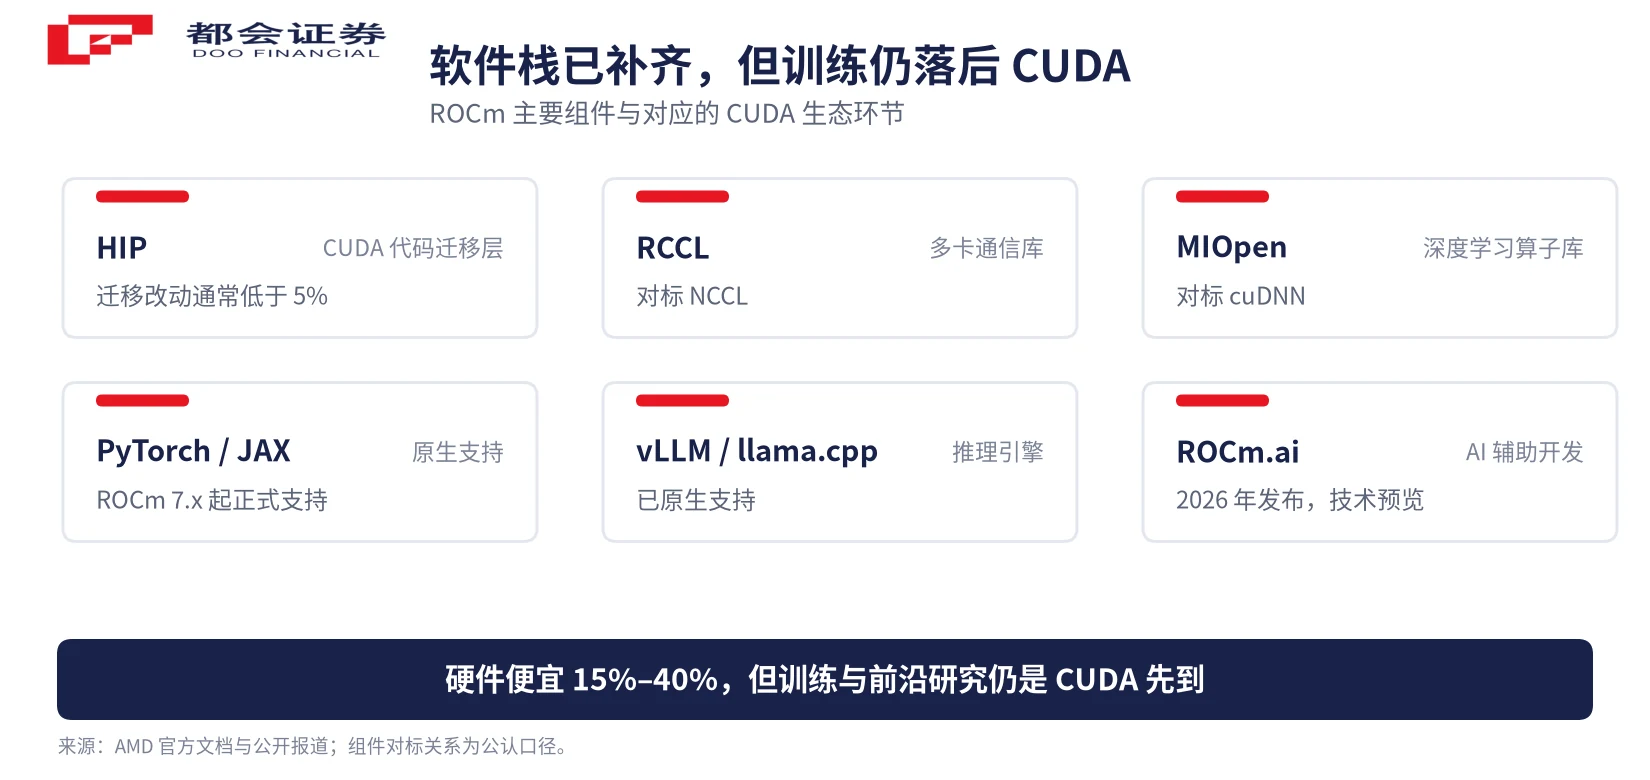
最直接的变化是框架支持。ROCm 7.x 已原生支持 PyTorch 2.9、vLLM 与 llama.cpp 这些主流工具链;PyTorch 与 JAX 也提供了原生 ROCm 支持。这意味着开发者不再需要打一堆补丁才能把模型跑起来。配套的组件也基本对齐:HIP 负责承接 CUDA 代码迁移,RCCL 对应多卡通信,MIOpen 对应算子库。2026 年,AMD 还发布了 ROCm.ai 用于 AI 辅助的 GPU 开发,目前处于技术预览阶段。
另一个侧面证据是使用量。AMD 表示 ROCm 的下载量同比增长约十倍。硬件侧,MI300X 最高提供 192GB 的 HBM3 显存,MI350X 提升到最高 288GB HBM3E,并支持 FP4 与 FP6 数据类型——单卡显存容量是 AMD 目前最明确的产品优势,直接决定了多大的模型或缓存能放在一张卡上。
不过,官方口径与开发者体验之间仍有落差。在非标准算子、旧一代显卡、以及部分推理引擎上,ROCm 的支持仍会遇到问题;每周都有新的研究代码只发布 CUDA 版本,这类「先到 CUDA」的惯性是生态问题,不是版本号能解决的。
ROCm 能打破 CUDA 的垄断吗?
短期内更现实的结果,不是取代,而是形成二分格局。
在推理和成本敏感的规模化部署上,ROCm 已经具备承接能力。理由很朴素:推理对算子覆盖的要求相对固定,主流模型的结构趋同,把吞吐调到 CUDA 的七八成、成本再低三成,账就划算。头部客户愿意为此投入工程资源做适配,这比任何基准测试都更有说服力。
但在训练、前沿模型架构以及依赖最新库的研究场景里,CUDA 仍会先到。原因在于生态的正反馈:新模型、新算子、新优化方法通常先在 CUDA 上实现并分享,教程、问答、排错经验也集中在 CUDA 社区。一个团队选择硬件时,考虑的不只是卡多少钱,还有遇到问题时能不能搜到答案。
所以判断 ROCm 的进展,有两个比基准数字更值得盯的指标:一是头部客户是否愿意把它用在训练任务上,而不只是推理;二是 AMD 能否把版本迭代的节奏稳定下来——开源生态最怕的不是落后,而是接口反复变动导致开发者流失。
对投资者意味着什么?
对 AMD 来说,ROCm 的价值不在于它本身能带来多少收入,而在于它决定了硬件能卖出去多少。软件栈是转化的门槛:客户要买卡,先得确认自己的模型能跑。
从投资角度,有三条线索值得持续跟踪。其一是客户承诺的兑现节奏——已公布的约 14 吉瓦承诺中,有多少按期进入部署,比协议规模更能说明问题。其二是训练场景的渗透:如果 ROCm 开始承载大规模训练任务,说明生态缺口正在实质收敛。其三是软件迭代的兼容性策略,频繁的接口调整会削弱开发者迁移意愿。
- 看部署节奏:承诺到交付的转化率,比协议总额更能反映真实需求。
- 看场景结构:推理占比下降、训练占比上升,才是生态成熟的信号。
- 看开发者侧口碑:第三方基准与社区反馈的变化,往往早于财报披露。
需要提醒的是,AI 芯片行业的叙事变化很快,软件生态的进展却是慢变量。对这类信息的判断,更适合放到季度甚至年度的尺度上,而不是跟随短期股价波动。本文用于说明 ROCm 的技术定位与生态进展,不构成投资建议。
常见问题(FAQ)
ROCm 主要面向 AMD 的数据中心加速卡(Instinct 系列)与部分消费级显卡,同时对 Radeon 与 Ryzen 产品线提供验证过的推理容器支持。它的定位是对标英伟达 CUDA 的通用 GPU 计算平台,不能运行在英伟达硬件上。
AMD 提供了 HIP 这一层迁移工具,设计上刻意模仿 CUDA 的 API 结构,多数项目的代码改动比例低于 5%,常规调用可通过 HIPIFY 自动转换。难点不在语法层,而在那些 CUDA 独有、尚无完整等价物的库,例如 TensorRT-LLM 与 FlashAttention 3。
按公开测试汇总,同级硬件上 ROCm 的推理吞吐约为 CUDA 的 75% 至 90%,差距较两年前明显收窄(MI300X 世代约为 37% 至 66%)。但训练与大模型微调的差距更大——多卡通信、FP8 训练配方等环节,CUDA 的工具链更成熟。
三个原因:价格、供应与议价。AMD 硬件价格较同级英伟达方案低 15% 至 40%;在先进封装产能紧张的背景下,多一个供应商意味着多一份交付保障;而在集中采购中,拥有第二个可选方案本身就是议价筹码。这些客户的采购决策并不以软件生态完全成熟为前提。
短期内更可能形成的是「二分格局」:在推理与成本敏感的规模化部署上,ROCm 已经可以承接;在训练、前沿模型架构与需要最新库支持的研究场景里,CUDA 仍会先到。软件生态的追赶快慢取决于两件事——头部客户愿不愿意投入工程资源适配,以及 AMD 能否把版本迭代的节奏稳定下来。
口径说明:① 性能差距为开发者非正式基准与第三方测试汇总,随工作负载类型差异很大;② 客户算力承诺为多年、多代产品的累计规模,非单年交付量;③ 组件对标关系为业界公认口径,各组件成熟度不同;④ 硬件价格差距为公开报价与行业汇总口径。