
 简体中文
 English

买英伟达股票之前,要看懂 GPU、CPU、NVLink 和 AI 数据中心
本文目录
五个层级加在一起,才是它卖的东西
先说结论:英伟达在 AI 数据中心里卖的不是一件商品,而是五个层级——计算、编排、机架内互联、机架间网络,以及把前四样装成一座可运行系统的能力。这五层各自解决不同的问题,也各自计价。
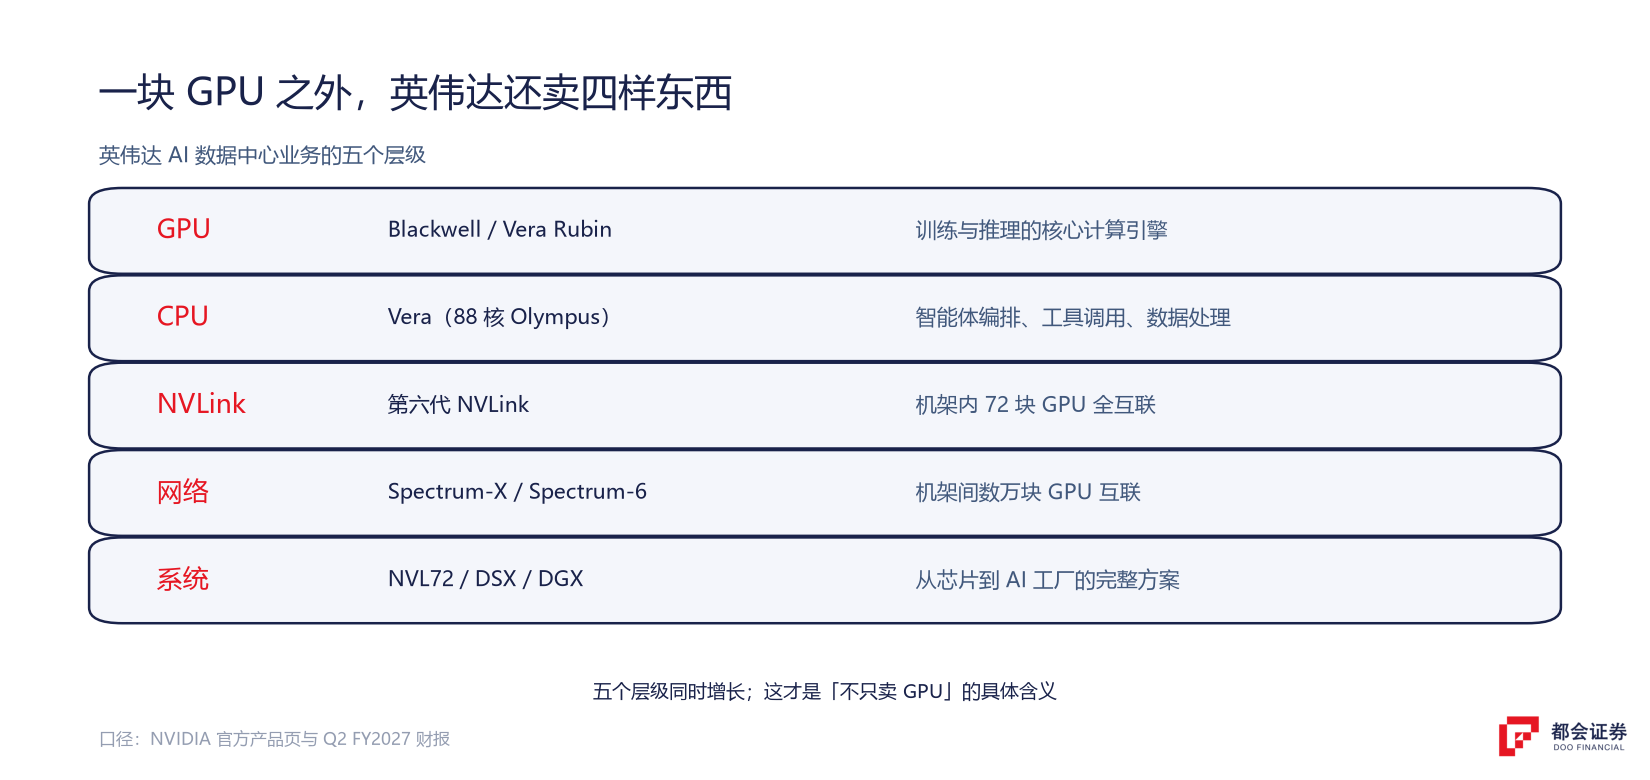
这五层同时增长的原因不复杂。当一座 AI 数据中心的规模从几块 GPU 扩到几万块,瓶颈会依次出现在不同的地方:先是算力不够,然后是内存带宽不够,接着是 GPU 之间的互联不够快,再然后是机架之间传不动数据,最后是整个系统没人帮你装起来、跑起来。
每一层瓶颈,对应一类产品。下面逐个看。
GPU:训练和推理都压在这一层
GPU 是英伟达的根基,也是 AI 数据中心里最贵的单一部件。
它在数据中心里干两类活:训练——用大量数据反复调整模型参数;推理——用训好的模型生成输出。这两类活对算力的需求是叠加的,不是互相替代的。大模型从单纯的文本生成走到今天的推理模型、智能体和测试时计算,每一步都在往上加负载。
当前主力架构是 Blackwell,采用第二代 Transformer Engine,配合 Tensor Core 加速大语言模型和混合专家模型(MoE)的训练与推理。在 MLPerf Training 6.0 这一轮基准测试中,Blackwell 平台在全部七项基准里都取得了最快的训练时间,也是唯一在全部基准都提交结果的平台;在 Artificial Analysis 的 AgentPerf——业界首个智能体 AI 基础设施基准——首轮结果里,GB300 NVL72 每兆瓦可支持的并发智能体数量达到上一代的 20 倍。
下一代平台 Vera Rubin 接着往上走,继续提升训练、推理与智能体工作负载的效率,已从 8 月起量产出货。
| 平台 | 代际定位 | 关键能力 |
|---|---|---|
| Hopper | 上一代 | AI 训练与推理的基础加速计算 |
| Blackwell | 当代主力 | MoE 模型支持、机密计算、MLPerf 领先 |
| Vera Rubin | 新一代(已量产出货) | 继续提升训练、推理与智能体工作负载效率 |
CPU:智能体在等的那一层
GPU 负责高密度计算,但 AI 工作负载不全是计算。模型推理之前的编排、工具调用、代码执行、数据分析和长上下文状态管理,这些活由 CPU 干。
英伟达为这一层准备了 Vera CPU。它搭载 88 颗定制的 Olympus 核心——NVIDIA 专为智能体 AI 与强化学习这类控制密集、对延迟敏感的工作设计的 CPU 核心,配 LPDDR5X 内存,带宽最高 1.2 TB/s;通过 NVLink-C2C 与 GPU 之间还能做到 1.8 TB/s 的一致性互联带宽。
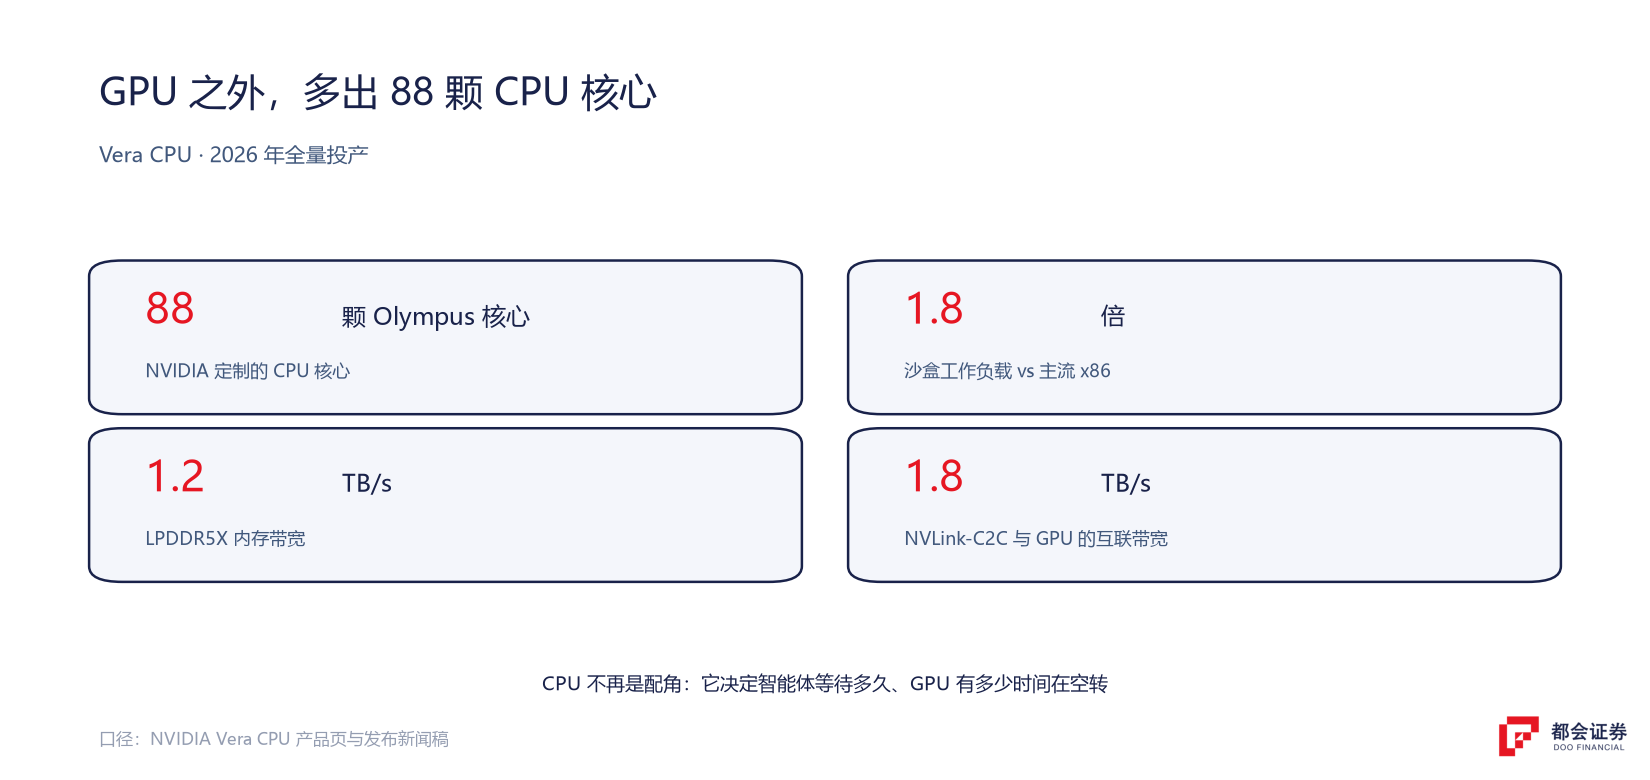
它的意义可以用一个数字说明:官方给出的沙盒工作负载性能,是主流 x86 CPU 的 1.8 倍。在智能体的推理循环里,CPU 要查 SQLite、编译生成的代码、跑 Python 工具链、用正则解析输出——每一步慢一点,GPU 就多等一会。CPU 快一点,等待就少一点。
Vera 现已全面投产。首批系统已交付给 Anthropic、OpenAI、Oracle Cloud Infrastructure 和 SpaceXAI;OCI 等云服务商在计划大规模部署。它同时充当 Vera Rubin 平台的主机 CPU,也能作为独立的 CPU 服务器单独部署。
NVLink:把 72 块 GPU 连成一个加速器
模型变大之后,单块 GPU 的算力和显存都不够用,得把多块 GPU 连起来协同工作。干这件事的是 NVLink——英伟达的 GPU 间高速互联技术。
第六代 NVLink 给每块 GPU 提供 3.6 TB/s 的双向带宽,是上一代的 2 倍,也是 PCIe Gen6 的 14 倍以上。
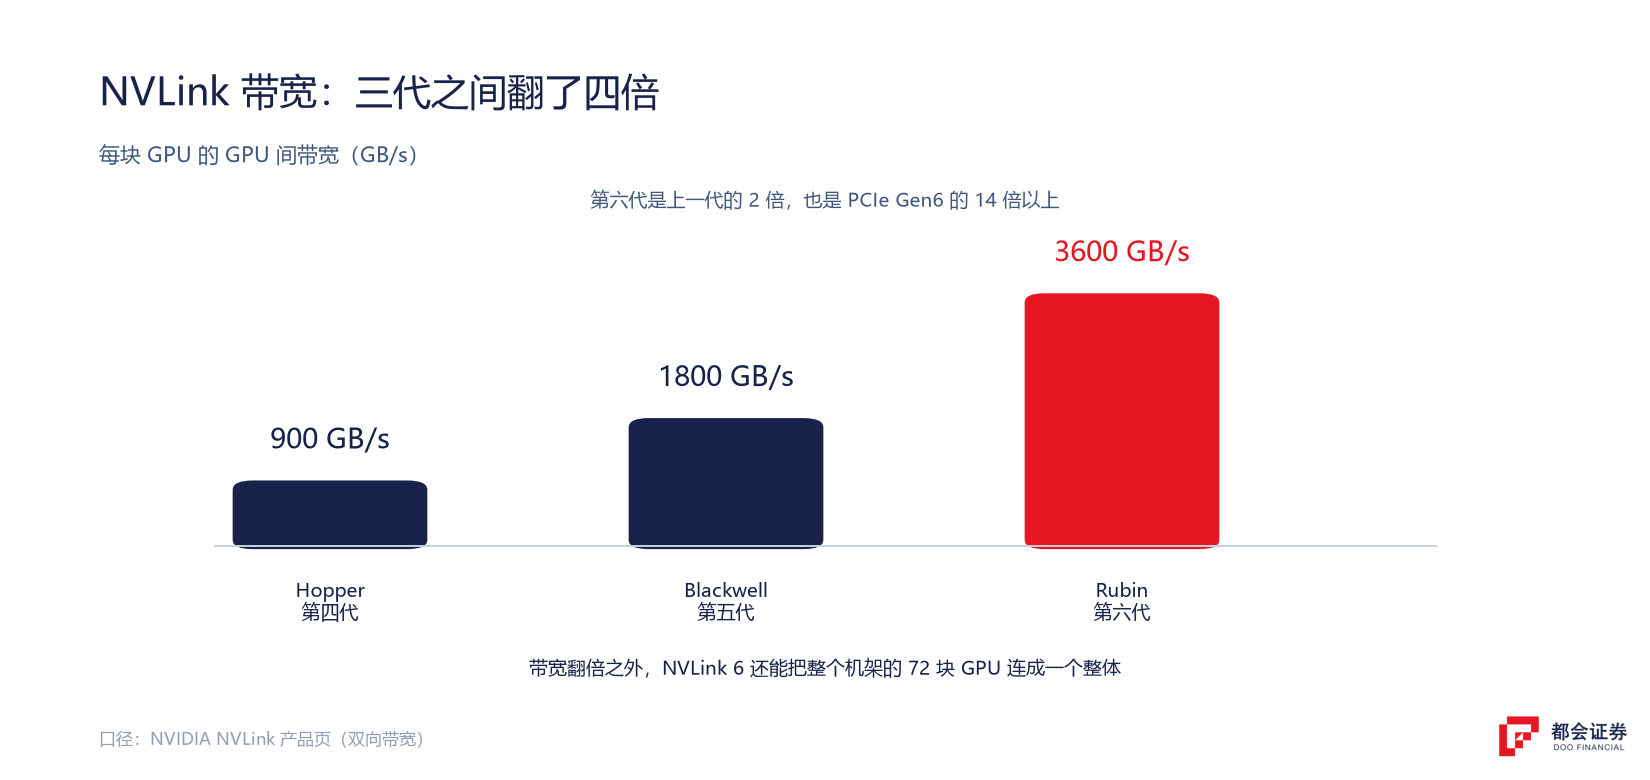
比速度本身更重要的,是它能连成什么规模。Vera Rubin NVL72 用 all-to-all 拓扑把 72 块 GPU 连成一个整体,机架级总带宽达到 260 TB/s,整个机架可以当作一台加速器来用,最高提供 3.6 exaFLOPS 的 AI 算力。对混合专家模型来说这一点尤其关键——这类模型需要 GPU 之间频繁做全对全通信,带宽和延迟直接决定它跑不跑得起来。
| NVLink 代际 | 每 GPU 带宽 | 机架级总带宽 | 对应平台 |
|---|---|---|---|
| 第四代 | 900 GB/s | 7.2 TB/s(单个 NVLink Switch 芯片) | Hopper |
| 第五代 | 1,800 GB/s | 130 TB/s(NVL72 机架) | Blackwell |
| 第六代 | 3,600 GB/s | 260 TB/s(NVL72 机架) | Rubin |
第六代 NVLink Switch 还加了控制平面弹性、部分装机机架可继续运行、交换机托盘热插拔这些运维功能。机架越贵,停机代价越高,这些功能的分量也就越重。
网络:把几万块 GPU 连起来的那一层
NVLink 解决的是一个机架内 72 块 GPU 的互联。当一座 AI 数据中心要部署几万甚至几十万块 GPU,机架之间的数据传输就交给网络。
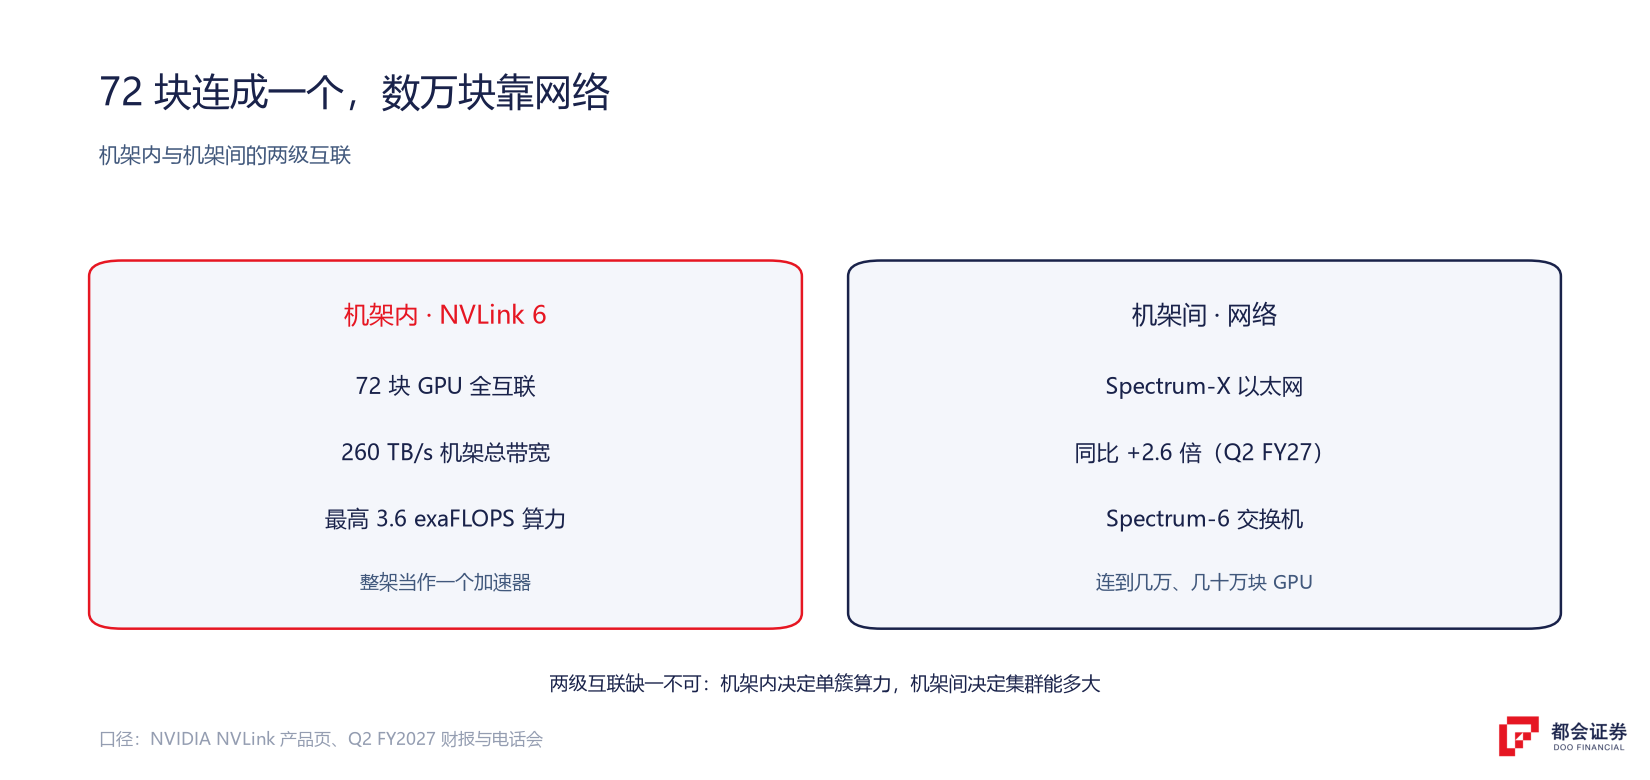
英伟达在这一层有两条路线:Spectrum-X 以太网,面向 AI 工厂设计的以太网架构,Q2 FY2027 收入同比增长 2.6 倍,同期网络业务整体创下季度纪录;以及新一代的 Spectrum-6 交换机系统,支持可插拔与共封装光学器件,作为 Vera Rubin 平台的一部分部署在各地的吉瓦级 AI 工厂中。
这里有个容易被忽略的差别:传统数据中心的网络是”连接服务器的管道”,AI 数据中心的网络是”计算的一部分”。集群越大,网络对整体性能的影响越直接——它不再是买 GPU 时顺手配的附件,而是一项独立且持续增长的采购。
系统:从一堆芯片到一座 AI 工厂
把 GPU、CPU、NVLink 和网络凑齐,还不等于能跑。英伟达在这之上还有一层——把这些部件装成可运行系统的方案。
- Vera Rubin NVL72。72 块 GPU 组成的机架级系统,是 AI 工厂的基本构建单元。
- DSX 平台。面向 AI 工厂的参考设计平台,帮基础设施建造者加速投产、提升每兆瓦的 token 吞吐。
- DGX SuperPOD。交钥匙式 AI 超级计算机方案,用于最严苛的大规模训练与推理。
- DGX Station。官方称其为”终极桌面 AI 超级计算机”,用于在本地开发和运行智能体。
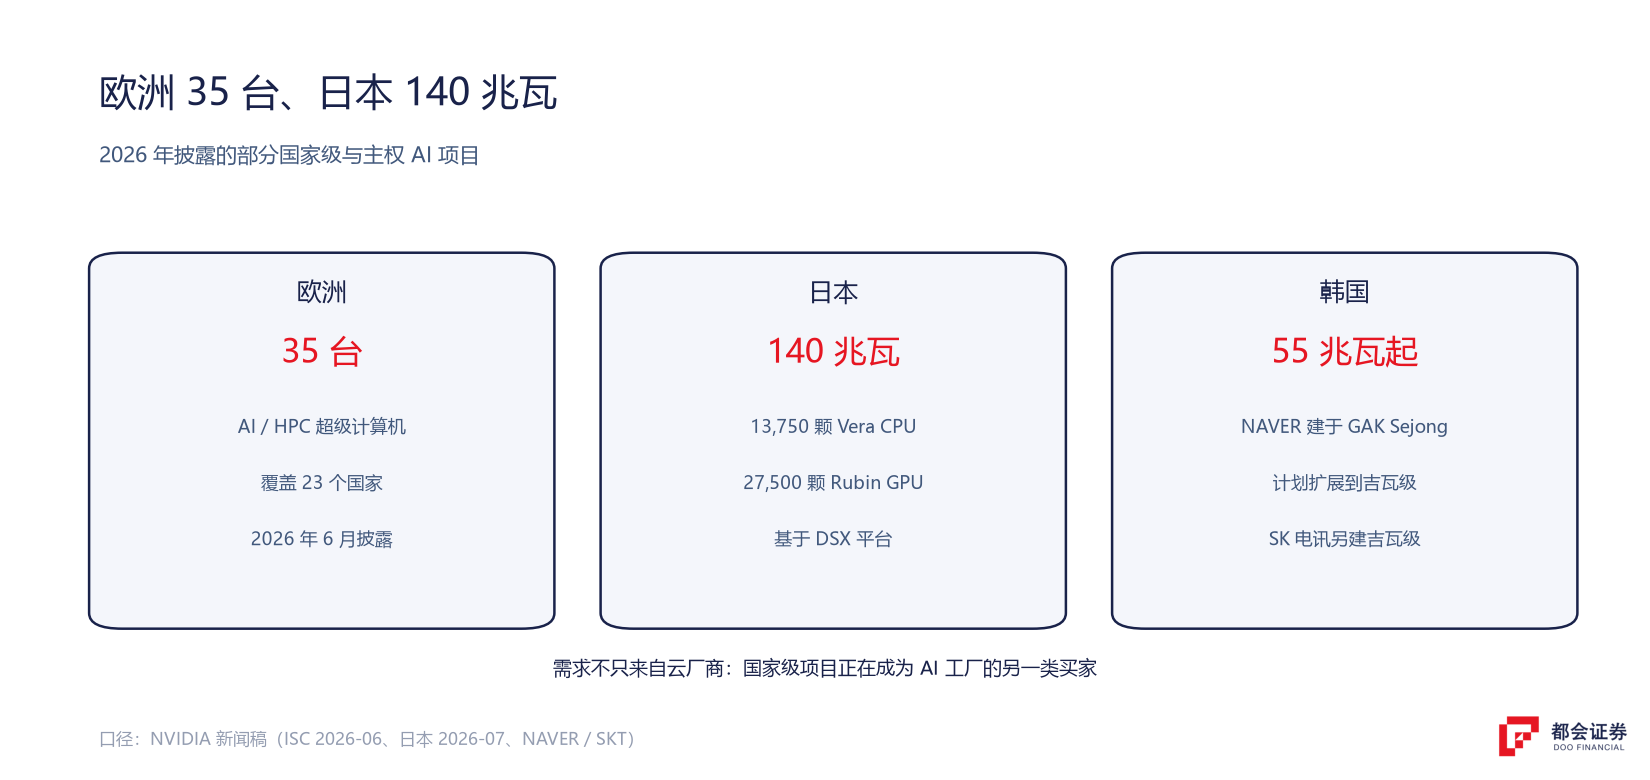
这一层的买家正在变多。据官方披露,欧洲正在开发 35 台 AI/HPC 超级计算机、覆盖 23 个国家;日本在 7 月宣布建设全球首个面向物理 AI 的国家级 AI 基础设施,由 Noetra 建设、经济产业省支持,规划 140 兆瓦容量、13,750 颗 Vera CPU 与 27,500 颗 Rubin GPU,架构基于 DSX 平台;韩国方面,NAVER 在 GAK Sejong 建设、从 55 兆瓦起步并计划扩展到吉瓦级,SK 电讯也在建吉瓦级 AI 工厂。
需求不再只来自超大规模云厂商。国家级与主权项目的加入,意味着这座市场的买家结构本身也在变宽。
从卖 GPU 到卖一套基础设施
把上面五层归拢一下,英伟达卖给一座 AI 数据中心的东西是三样:
- 计算。GPU 做训练和推理,CPU 做编排与数据处理。
- 互联。NVLink 连机架内的 GPU,网络连机架间的 GPU。
- 系统。把前两样组装成一座能跑起来的 AI 工厂。
当一座数据中心的规模从几块 GPU 扩到几万块,这三层的需求是同时往上走的。英伟达的产品线覆盖了全部三层——这就是”它不只对应 GPU 这个单品”的具体含义。
回到开头的那个数字:890 亿美元的数据中心收入里,GPU 是主体,但网络、CPU 和系统已经不是零头。知道了这五层各自是什么、解决什么问题,再看它下一代产品会带来什么变化时,看的就是几个具体部件,不再是一个抽象概念。
如果你想接着了解交易这只股票本身涉及的账户与操作,可以看英伟达股票怎么买那篇;想先建立研究一只美股的方法,可以看研究一家美股公司:先别急着看涨跌。
关于英伟达的产品线,几个常见问题
不只。除了 Blackwell、Vera Rubin 这些 GPU,它还有 Vera CPU、NVLink 互联、Spectrum-X 与 Spectrum-6 网络产品,以及 NVL72、DSX、DGX SuperPOD 这些整机与系统方案。2027 财年第二财季数据中心收入 890 亿美元,其中网络业务创下季度纪录、Spectrum-X 同比增长 2.6 倍。
管的范围不同。NVLink 管机架内 72 块 GPU 的全互联(第六代每块 GPU 3.6 TB/s、机架总带宽 260 TB/s);网络管机架之间几万块 GPU 的连接(Spectrum-X 以太网)。前者决定单簇的算力密度,后者决定整个集群能扩多大。
它负责 AI 工作负载里的编排与数据处理——工具调用、代码执行、数据分析、长上下文状态管理。搭载 88 颗定制 Olympus 核心,沙盒工作负载性能为主流 x86 CPU 的 1.8 倍,现已全面投产。
因为规模扩大会依次撞上不同瓶颈:算力、内存带宽、GPU 间互联、机架间网络、整机集成。每一层瓶颈都需要对应的硬件投入,这也是 AI 数据中心单柜价值远高于传统服务器机柜的原因。
NVL72 是由 72 块 GPU 组成的基本构建单元;DGX SuperPOD 是可在其之上扩展的交钥匙式 AI 超级计算机方案,用于大规模训练与推理部署。前者是积木,后者是用积木搭起来的完整方案。
用处在于判断增长来自哪里。如果收入增长主要来自 GPU 出货,那它就受制于 GPU 的产能与价格周期;如果网络、CPU 和系统同时放量,说明它在一座数据中心里的可计价范围在扩大。本文只解释产品结构,不构成任何投资建议。
口径说明:① NVLink 为双向带宽,第四代「7.2 TB/s」指单个 Switch 芯片、第五六代指 NVL72 机架总带宽,不可直接相比;② 财年与自然年不一致(Q2 FY27 = 2026 年 5–7 月);③ 性能数字为公司口径;④ 国家项目为规划值,非已建成容量。


