
 简体中文
 English

甲骨文一天接入五家硅片:谷歌 TPU 上架,网络层留给自己
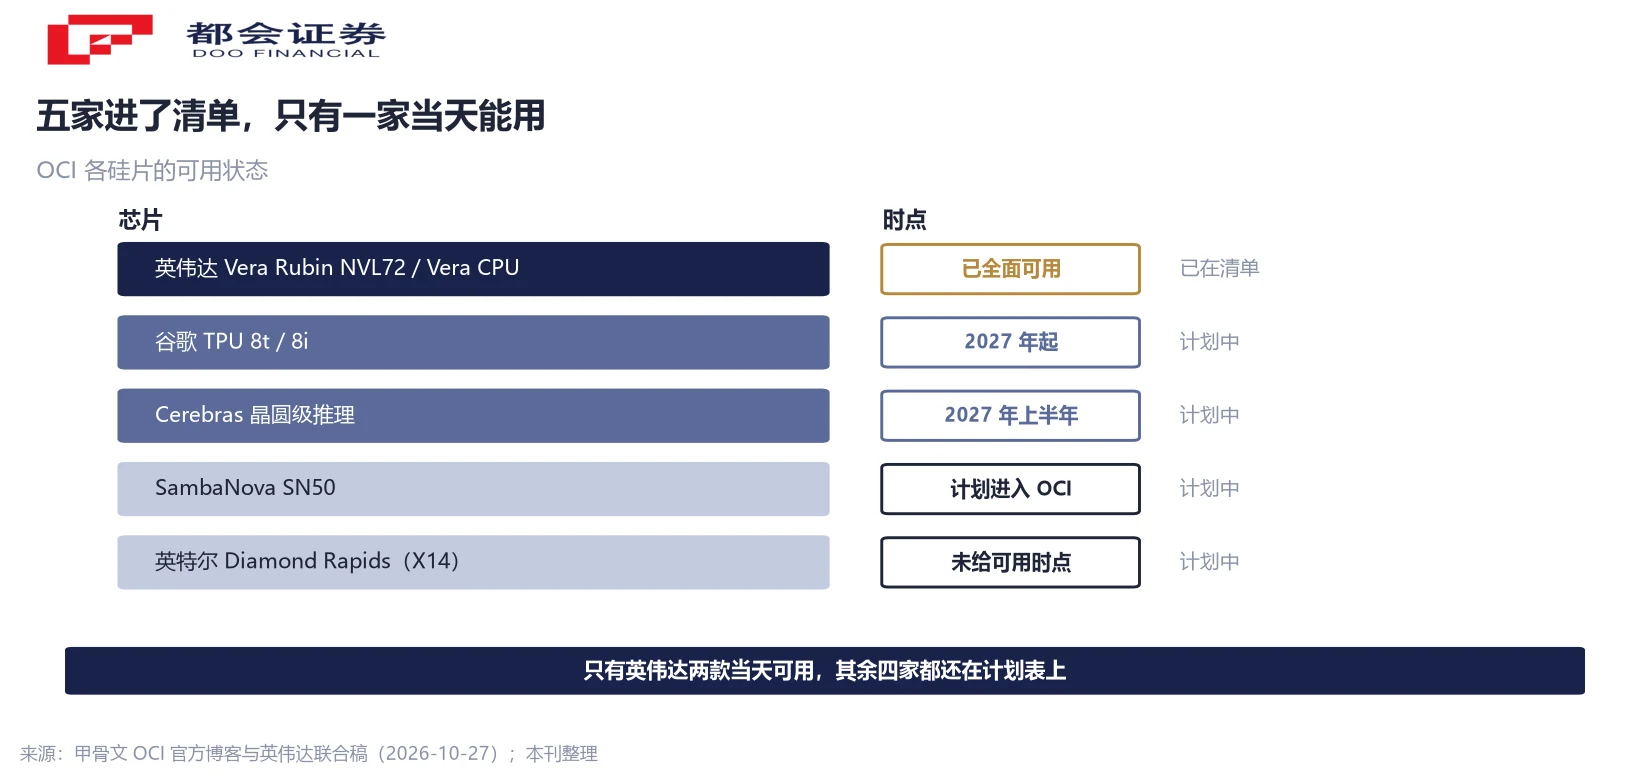
10 月 27 日,甲骨文在拉斯维加斯的 AI World 大会上把算力清单一次性摊开。当天进入 OCI 的硅片有五家:英伟达的 Vera Rubin NVL72 机架系统与 Vera CPU 当场转为全面可用,谷歌第八代 TPU 的 8t 与 8i 计划明年上线,Cerebras 的晶圆级推理计划明年上半年部署,SambaNova 的第五代 SN50 进入 OCI 数据中心,英特尔的 Diamond Rapids 写进计划中的 X14 实例。AMD 的第六代 EPYC 与 Instinct MI455X 也在同一份清单里。
这条消息容易读成「甲骨文多接了几家供应商」。同一份公告里还有一条更容易被忽略:即便跑在英伟达的系统上,甲骨文也要在某些配置中跳开英伟达的部分网络芯片,换用自己的 Acceleron。
OCI 总裁 Mahesh Thiagarajan 的表述是把选择权交给客户:不同 AI 工作负载有不同算力需求,客户可按性能、吞吐量和经济性为每类负载挑基础设施。五家硅片都挂在这句话下面。
一天里,五家硅片进了同一朵云
先按类别把清单分开,它们对应的活不一样。训练这一端,英伟达的 Vera Rubin NVL72 与谷歌 TPU 8t 是主力;推理这一端,谷歌 TPU 8i、Cerebras 的晶圆级引擎、SambaNova 的 SN50 指向同一个位置;通用计算与智能体调度这一端,英伟达 Vera CPU 已全面可用,英特尔 Diamond Rapids 与 AMD 第六代 EPYC 分别写进计划中的 X14 与 E7 实例。
这几家进入的时间点并不相同,这一点常被合并成一句话读过去。英伟达的两款产品是当天转为全面可用,属于已经能下单的状态;谷歌 TPU、Cerebras 的晶圆级推理、英特尔 Diamond Rapids 都标着计划,其中 TPU 与 Cerebras 指向明年,Diamond Rapids 连可用时点都没有给。
把「已经能用」与「计划中」混在一起,会得出一个过快的结论。甲骨文这次的动作有两半:一半是把芯片菜单加长,另一半是把接这些芯片的那层网自己做。
被换掉的是哪一层网络
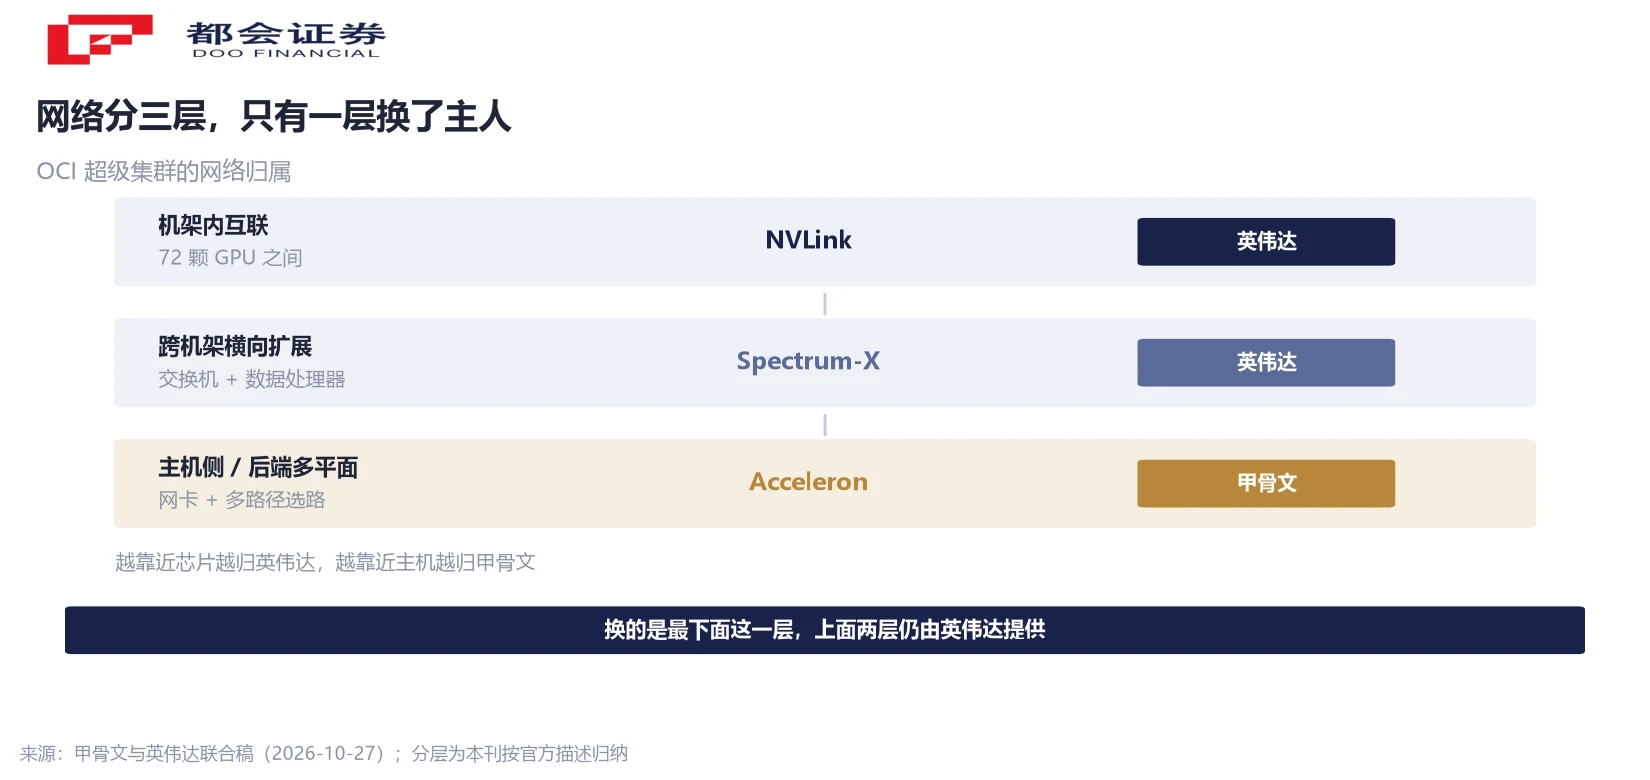
「弃用英伟达网络芯片」这个说法需要限定到层,否则会读成英伟达的整套网络被替掉。英伟达与甲骨文同日发布的官方稿把两套网络并列写在同一句里:OCI 超级集群由 NVL72 机架系统、甲骨文 Acceleron 网络、英伟达 Spectrum-X 以太网(含 Spectrum-6 交换机与 BlueField-4 数据处理器)、以及吉瓦级供电与散热共同组成。
跨机架的横向扩展仍走英伟达的以太网,机架内 72 颗 GPU 之间仍走 NVLink,换掉的落在主机侧与后端多平面网络这一层。甲骨文自己的描述是:Acceleron 把专用网络架构、融合网卡、零信任路由与多条网络路径合成一层,这一轮新增了前端 RDMA 连接与多平面网络的自动选路。
分层看,这条安排比「多接一家芯片」的分量重。GPU 决定单卡算得快不快,网络决定几千张卡能不能一起算;在这一层上做主,等于在别人的芯片之上铺一张自己的底座。Futurum 的判断是,甲骨文的第一方硅片就在网络这一层。
谷歌的 TPU 用自家 ICI 做片间路由、外面套光电路交换。定制网卡的作用在这里:让 TPU 在集群内保留原生互联,同时把集群外的存储与数据库接进 OCI 的统一账单。
200 亿额度:投资者日把钱的答案给了
公告当天,甲骨文没有披露多吉瓦对应的具体吉瓦数、投资金额与完整交付时间表,也没有说芯片采购怎么融资。这三个空白在一天后被投资者日填上。
10 月 28 日的投资者日给出的路径是:资本开支在 2027 与 2028 两个财年见顶,2029 财年回落;自由现金流在 2028 财年下半年转正,2029 财年不低于 300 亿美元。数据中心容量方面,未来几年新增 7 吉瓦,到 2028 财年末总容量超过 10 吉瓦。融资纪律方面,2027 至 2030 财年的投资周期内,额外融资不超过 200 亿美元,股权与债务各约一半。
11 月 2 日,这 200 亿一次性落定。86,206,897 股普通股定价 116 美元,较 10 月 30 日收盘 130.67 美元折价 11.2%,净募资约 99 亿美元;同日发行五档优先票据——2029 年到期 20 亿美元、票息 7.000%,2031 年到期 17.5 亿美元、7.450%,2033 年到期 22.5 亿美元、7.850%,2037 年到期 25 亿美元、8.000%,2046 年到期 15 亿美元、8.650%,合计 100 亿美元、净募资约 100 亿美元。
两笔加总 199 亿美元,对 200 亿上限只剩 1 亿。承诺的额度没有留余量,一轮用满;这也解释了定价为什么折价。
公告当天的「未披露融资安排」并非回避,答案留给了第二天的投资者日。五家硅片的价格仍未公布,但钱从哪来、什么时候回正都给了数。
为什么多元化先从推理开始
新增的几家里,有三家是做推理的:Cerebras 的晶圆级引擎、SambaNova 的 SN50、谷歌 TPU 8i。它们占的位置不一样,但指向同一段工序。
SambaNova 的公开说法把分工写得最清楚:GPU 负责 prefill,把输入转成中间状态;SN50 负责 decode,逐字生成,而 decode 决定了智能体响应有多快。SN50 单机架平均功耗 20 千瓦,可以在现有风冷数据中心里铺开。Cerebras 的路径相近,把计算与内存放在同一片晶圆上,减少数据搬运的往返。
这条分工解释了为什么先动推理。训练要的是单卡算力与卡间带宽的极限,推理要的是每次调用有多快、有多便宜。智能体一天要跑几十上百次模型调用,延迟与单位成本都按调用次数累加。
机构测算给了一个量级参照:Futurum 预计到 2030 年,推理占数据中心 AI 加速器需求的 73%,市场总额 1.21 万亿美元,其中智能体与推理优先型负载 5,460 亿美元。这是机构预测而非公司口径,只能用来理解各家为什么在这一段集中押注。
对甲骨文自己,这一段已有可对照的体量:2027 财年第一季度云基础设施收入 74 亿美元、同比增 121%,剩余履约义务 6,640 亿美元、同比增 2,090 亿美元。履约义务是已签约未确认的部分,不能当当期收入读;公司预计其中约一半在未来 36 个月内转化。
Cerebras 的对照:进了机房不等于赚到钱
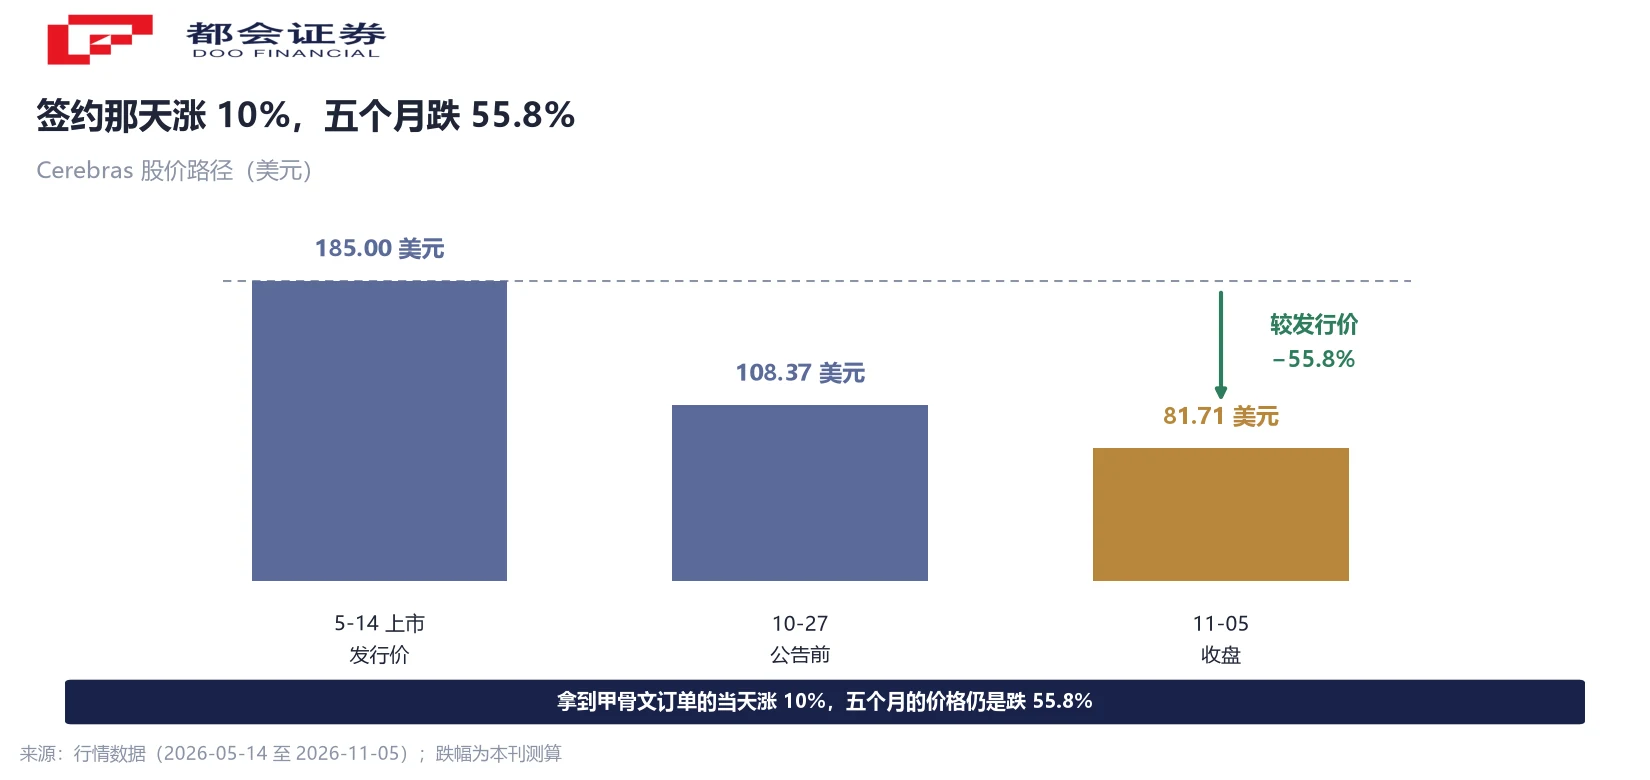
Cerebras 是这次公告里反应最直接的一家。消息公布后其股价盘中一度涨超 10%。把时间拉长画面不同:11 月 5 日收 81.71 美元,较 5 月上市时 185 美元的发行价跌 55.8%。
「进了大厂机房」与「赚到钱」是两件事。甲骨文没有披露会采用多少 Cerebras 产品,也没有给容量与定价;Cerebras 今年全年营收预计不到 10 亿美元,而英伟达单季营收接近 1,000 亿美元。
五家硅片进同一朵云,改变的是甲骨文的选择权,这五家各自的份额没被改动。客户要的是在一张账单里挑不同架构,供应商要的是订单落地——两件事之间的时差,正是上面那个股价对照在说的事。
接下来看什么
第一条是多吉瓦对应的具体吉瓦数与交付时点。公告只给定性表述,投资者日给的是全公司 2028 财年末超过 10 吉瓦的总容量目标;两个数字不能相加也不能互换——一个是这批 Vera Rubin 系统的规模,一个是全部容量的期末数。
第二条是 Acceleron 在英伟达系统里的实际占比。一手稿写的是「某些配置」,没有给比例。这条决定「网络自己做」当期能落到多少机架。
第三条是明年 TPU 上线时先跑哪一类负载。谷歌给的是 8t 对训练、8i 对推理,甲骨文没有说先上哪一个;TPU 在 OCI 的实际负载结构,会比任何发布会表述都更能说明这次多元化的成色。
另两个外部变量值得一起看:甲骨文五年期信用违约互换利差一度触及约 320 个基点,年内涨幅近一倍,该水平通常对应高收益级信用;公司已发行长期债务约 1,170 亿美元。融资纪律能否压住这个读数,比 200 亿额度本身更值得跟踪。
常见问题
不是。英伟达的 Vera Rubin NVL72 与 Vera CPU 是当天转为全面可用的主力,甲骨文还要把基于它的超级集群扩到多吉瓦规模。被替换的只是网络芯片里的一部分,且限于某些配置。
跨机架的横向扩展仍走英伟达 Spectrum-X 以太网与 Spectrum-6 交换机,机架内 72 颗 GPU 之间仍走 NVLink;换掉的是主机侧网卡与后端多平面网络这一层,改由甲骨文的 Acceleron 承担。这一层决定几千张卡能不能一起算,属于把各家芯片接起来的底座。
区别在账单和编排。客户可以在 OCI 里同时买英伟达 GPU、TPU 与其他加速器,用同一套存储、数据库与网络;甲骨文称自己是谷歌之外第一家提供 TPU 的超大规模云厂商,计划 2027 年起分阶段放量。
甲骨文与英伟达都没有披露具体吉瓦数、投资金额与完整交付时间表。黄仁勋此前说过 Vera Rubin 系统每吉瓦部署最高可为英伟达带来 400 亿美元营收,那是英伟达的收入口径,不能乘上来当作甲骨文的采购价。
是投资者日承诺的 2027 至 2030 财年额外融资上限,股权与债务各约一半。11 月 2 日定价的 99 亿股权加 100 亿债务合计 199 亿,基本用满;此前完成的 200 亿美元市价增发不在这 200 亿之内。
公司口径是 2028 财年下半年转正、2029 财年不低于 300 亿美元,路径是资本开支在 2027 与 2028 两个财年见顶后回落。这是公司给出的目标,不是已实现的结果,兑现程度要看后续季度的资本开支与云基础设施收入。
公告没有披露采购量、容量与定价,订单规模无法量化;公司今年营收预计不到 10 亿美元,与英伟达单季接近 1,000 亿美元不在一个量级。股价反映的是对未来现金流的预期,签约与确认收入之间隔着交付与验收。
口径说明:①「多吉瓦」为定性表述,未披露吉瓦数、金额与交付表;②黄仁勋 400 亿美元/吉瓦为英伟达收入口径,不可折算为采购额;③199 亿与 1 亿余额为本刊测算;④73%、1.21 万亿、5,460 亿美元为机构预测;⑤剩余履约义务为已签约未确认收入,与当期营收不同口径。




