
 简体中文
 English

微软 Exchange Online 故障超 5 小时:服务器通不过健康检查,13.8 万起报告
美东 11 月 12 日上午 11:17,微软在 Microsoft 365 管理中心建了一个编号 EX1550543 的事件:美洲地区用户通过多种连接方式访问 Exchange Online 邮箱时出现问题。同一时段,另一起影响 Teams 的事件 TM1550488 也在处理中。
几个小时后,这不再是一个区域性的邮箱问题。故障监测机构 Downdetector 上,Outlook 的故障报告在下午 1 点前后达到 138,058 起;Teams、SharePoint Online、Microsoft 365 Copilot、Defender XDR 陆续被列入可能受影响清单。到傍晚 6 点,微软的表述仍是「正在把受影响的服务器送回服务」,并提醒用户客户端重新连接时,恢复是渐进的。
原因方向上,微软排除了请求量这一项。它的说法是:一部分基础设施在多个区域出现异常高负载,调查发现高负载并非来自流量增加,而是多台服务器意外不可用,把负载压到了剩余的基础设施上。这些服务器未能通过自动运行的健康检查。
结构上,Exchange Online 是 Outlook 的邮件服务端。它一停,邮箱访问先断,挂在同一套办公组件上的聊天、文件与外部 AI 连接器跟着受影响。
Outlook 报告峰值 138,058 起:5 小时里的三组数字
时间从美东 11 月 12 日上午 11:17 算起。微软在 Microsoft 365 管理中心建了事件编号 EX1550543,最初的表述是:正在调查美洲地区用户通过多种连接方式访问 Exchange Online 邮箱时遇到的问题。
报告量的攀升比官方措辞快。按 Downdetector 的数据,Outlook 的故障报告在下午 1 点前后达到 138,058 起,为当日峰值;至下午 5:47,Microsoft 365 相关的报告已回落到接近 13,000 起,Teams 为 763 起;傍晚时点,Outlook 报告约 34,490 起。
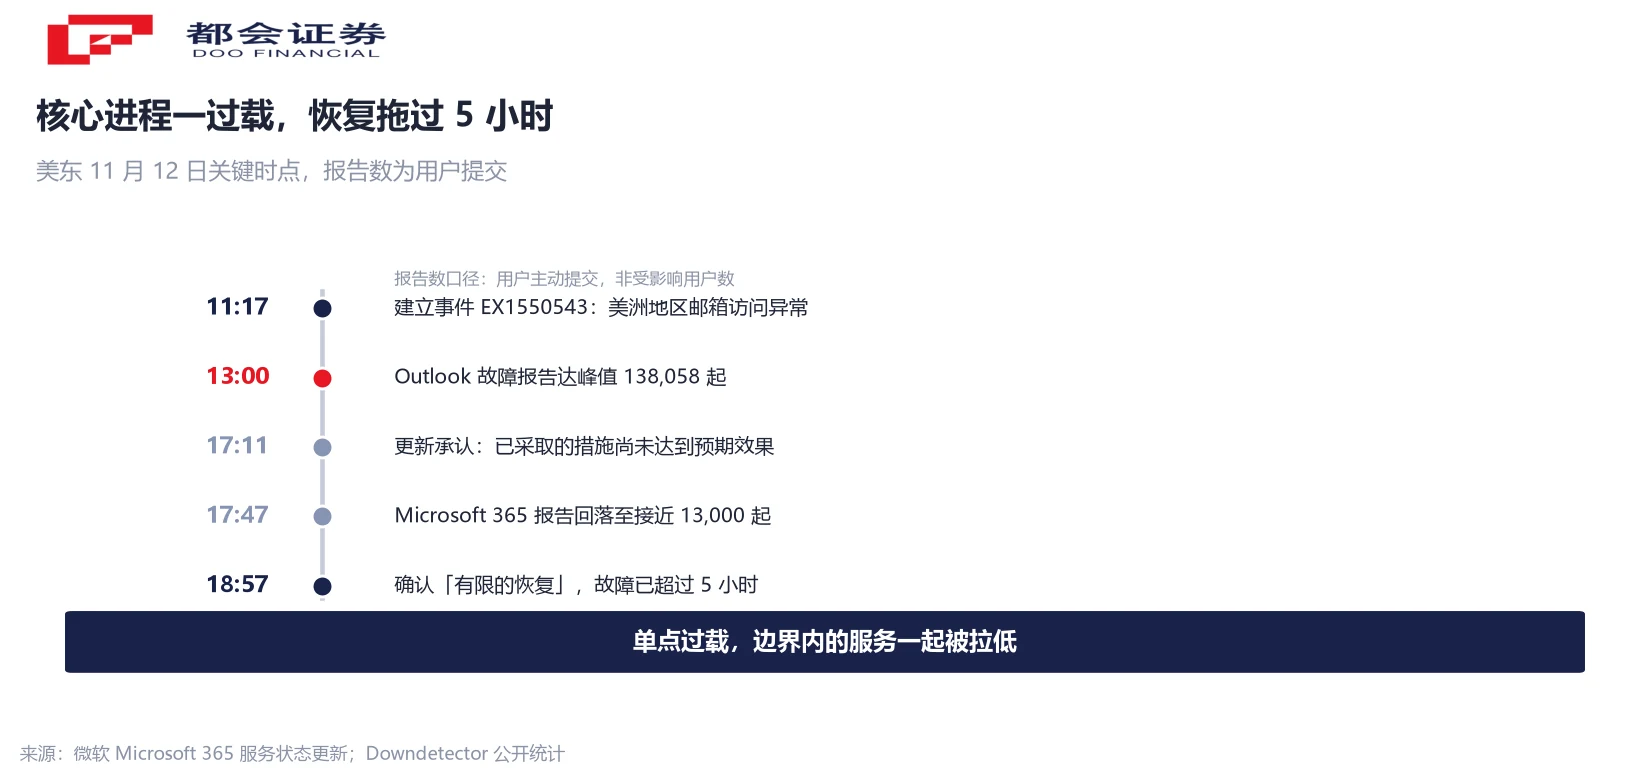
这里要先说清一条口径:这些是用户主动提交的「故障报告数」,不是受影响用户数。同一名用户可以重复提交,未提交报告的用户也可能受影响,两个数不能互换。
恢复的时间边界在傍晚。到下午 6 点,微软表示仍在把受影响的服务器送回服务,并称已观察到「有限的恢复」。从上午 11:17 到傍晚 6 点,超过 5 小时。
微软排除了请求量:多台服务器没能通过健康检查,核心进程随之过载
原因方向上,微软先后给过两版表述。第一版是:一部分基础设施在多个区域出现异常高负载。晚间更新里补上了机理解释——调查发现,高负载并非来自请求增加,而是多台服务器意外不可用,把负载压到了剩余的基础设施上。
这些服务器为什么不可用,微软指向自动健康检查。按它的说法,部分服务器未能通过自动运行的健康检查,因此被判定为不可用。微软正在调查参与这些检查的某个组件近期的改动是否相关,并把少量配置更新列为可能因素。
下午 5:11 的更新里出现了更具体的描述:「调查发现,受影响服务器上的一个核心进程过载,导致服务器停止响应,并造成容量损失。」同一则更新承认,此前采取的措施「尚未达到预期效果」。
微软发言人表示,目前没有网络攻击的迹象。处置动作包括三项:暂停所有部署与配置更新、把连接流量从受影响设施转移出去、重启受影响的服务器;此外还验证了一套替代的健康检查方法,让重启后的服务器能重新接入。
波及半径:74 个国家和地区、两家 AI 连接器,还有微软自己的状态页
先看地理范围。按 Downdetector 的统计,报告在约一小时内覆盖了 74 个国家和地区;在 17:00 至 18:55 UTC 之间,接近三成报告来自美国以外。微软最初的表述限定在美洲,随后扩大到「任何地区的用户都可能受影响」。
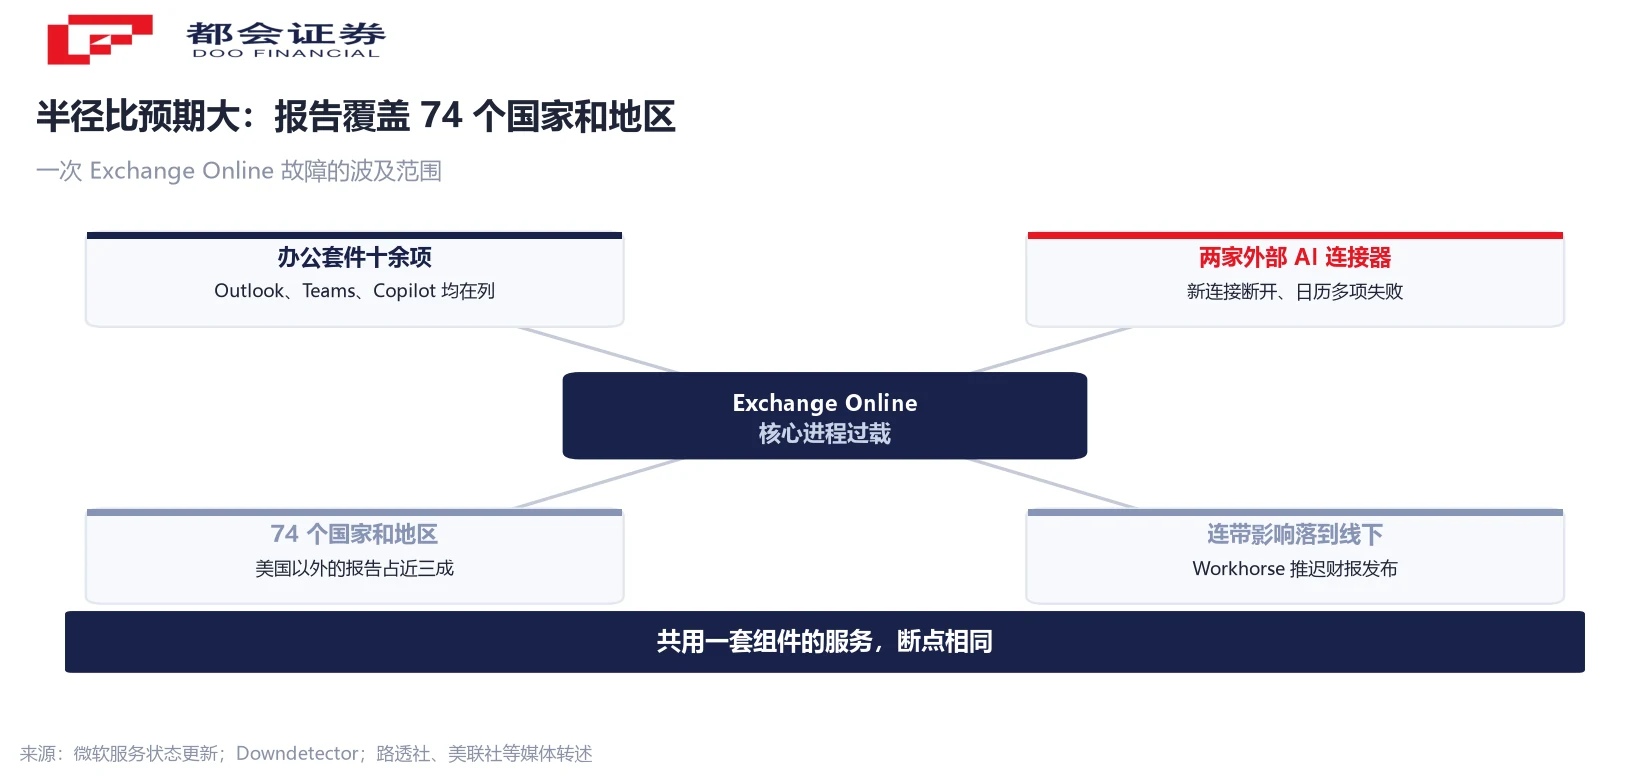
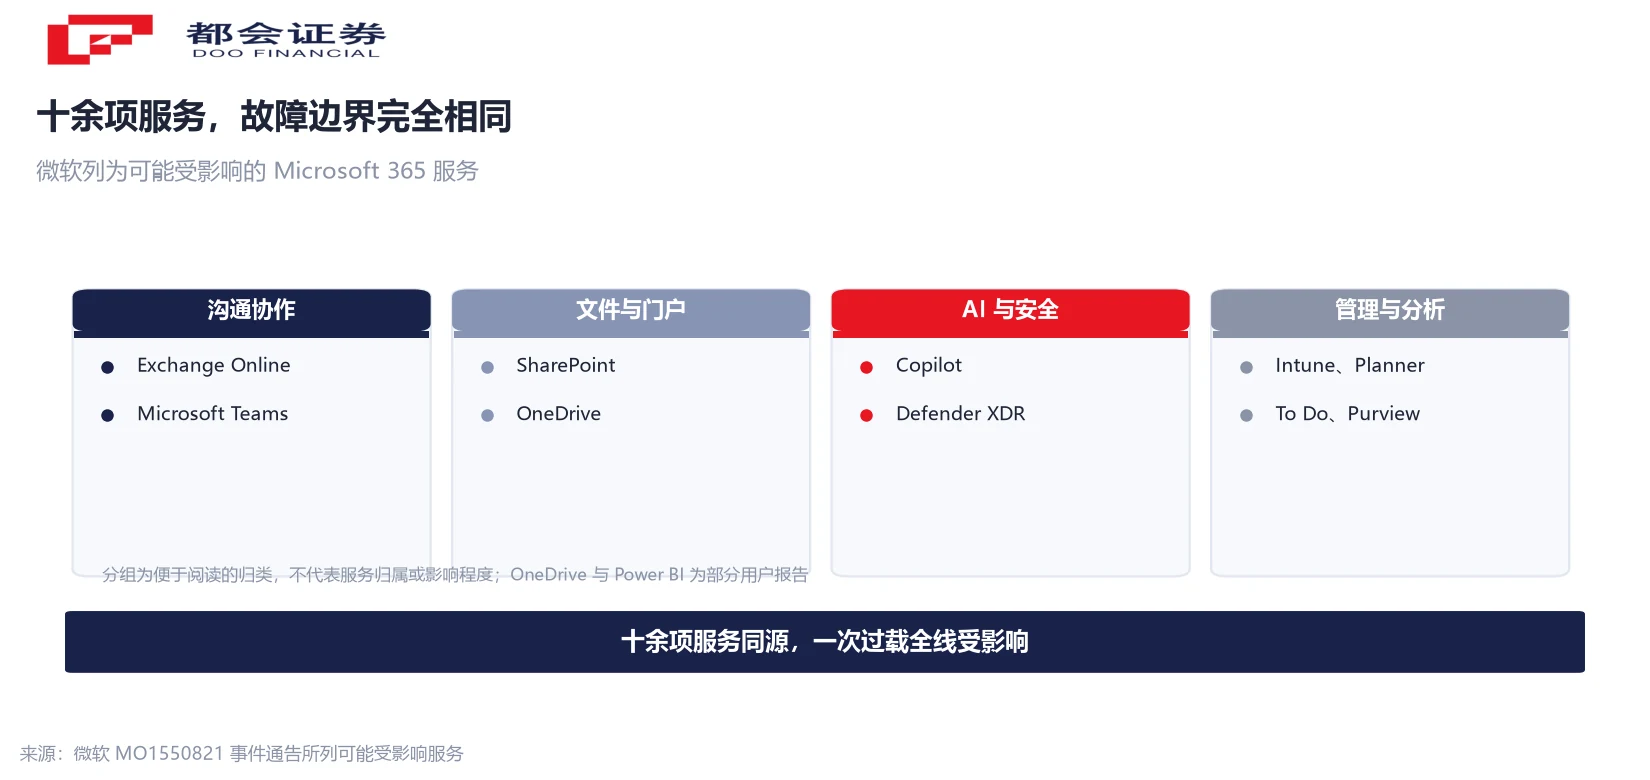
再看服务面。可能受影响的清单从 Exchange Online 一路加长:Teams、SharePoint Online、Microsoft 365 Copilot、Defender XDR 之外,后续加入 Defender for Office 365、Intune、Planner、To Do、Purview,以及部分 Power BI 与 Microsoft 365 应用管理中心的功能。
第三类是外部组件。OpenAI 称其微软连接器出现问题,新连接可能断开、工具未按预期工作;Anthropic 称上游提供商的问题影响了它的 Microsoft 365 连接器,截至当日 20:28(UTC)仍表示邮件、日历与搜索工具在多数请求上失败。两家公司都没有说明与微软这次故障的因果关系。
影响还落到具体机构与企业。据媒体报道,部分学区、大学与医院警告通讯可能受限,美国国会办公室的用户也受影响;电动卡车制造商 Workhorse Group 把原定当日的三季度财报发布推迟到 11 月 16 日。连微软自己的公开服务状态页,也因为压力短暂无法加载。
恢复为什么慢:重启的服务器,一接到流量就可能再次无响应
故障本身的时长是一回事,恢复的难度是另一回事。微软在更新里说明,已经把一部分受影响服务器送回服务,且它们「目前保持稳定」;但此前也发现,这些服务器一旦收到流量,可能再次变得无响应。
这就解释了恢复为什么拖长。当重启后的服务器能否扛住流量无法预先确认,工程师只能逐台处理、边观察边推进。微软同时表示,正在简化把剩余受影响服务器送回服务的流程。
验证环节也卡了一下。到当日 20:44(UTC)的更新,微软称许多受影响的服务器在验证一项针对性变更时停止响应,因此无法确认该项变更是否有效,只能带着变更重启这些服务器,再把同一做法推广到其他受影响区域。
还有一段容易被忽略的时间差。当天早些时候,微软曾表示北美一起 Teams 中断已修复、影响已完全解决;数小时后它又说明,问题可能影响任何地区的 Microsoft 365 服务连接。官方的「已解决」与用户的实际可用之间,隔着一段距离。
这也不是今年第一次。据媒体统计,本次是微软 2026 年内第三次重大 Microsoft 365 中断,前两次分别发生在 1 月(持续数小时)与 8 月(一次代码更新引发的故障);10 月另有一次 Azure 中断。
可用性挂在别人手里:这次断的不只是模型
把视线从微软挪开一步,这次故障说明一件对企业有实际意义的事:一家人工智能服务的可用性,不只取决于它自己的模型与机房。
OpenAI 与 Anthropic 的中断,发生在把 AI 接入 Microsoft 365 的「连接器」这一层——邮件、日历、搜索这些工具。模型没有停,连接它的那一段停了,用户侧感受到的就是 AI 用不了。在这条链路里,办公组件与身份组件是共同的底座。
集中度于是成为问题。当邮件、日历、聊天、文件、安全管理与外部 AI 连接器都挂在同一套云组件上,故障的边界就近似等于这套组件的边界。一次核心进程的过载,把边界内的服务一起拉低。
有学者把这类故障描述为级联。澳大利亚皇家墨尔本理工大学工程学院的 Mark Gregory 对媒体表示,故障看起来出在网络层,当一个服务器池失去部分成员,其余服务器就会过载,形成连锁;他建议企业为云服务保留备用方案。这是媒体转述的第三方观点,不代表本文判断。
本文不讨论服务水平协议条款、赔偿或恢复概率,也不对相关公司股价作任何判断。可核对的事实是:受影响服务清单与处置进展,微软公布在 EX1550543 与 MO1550821 两个事件编号下。
接下来看三件事:配置变更结论、替代健康检查、部署节奏
这次故障已经恢复,但有三条线值得继续跟。
- 那份配置变更的结论。微软提到少量近期配置更新可能与故障相关,并在测试一项「导致服务器通不过自动健康检查」的变更。它是否被确认为根因、改动涉及多大范围,会决定这次故障被归到哪一类问题。
- 替代健康检查方法有没有全面铺开。微软已在一部分服务器上验证了绕过问题组件的替代检查方法。它有没有推广到全部受影响区域,是判断恢复是否彻底的一条线索。
- 变更与部署的节奏会不会调整。本次处置的第一步是暂停所有部署与配置更新。放在年内第三次重大中断的背景下,微软后续怎么安排灰度与变更冻结,比单次恢复时长更值得跟踪。
这三条都不需要新的预测,只需要等微软下一次状态更新里的措辞变化。
常见问题
从美东 11 月 12 日上午 11:17 建立事件编号 EX1550543 算起,到当天傍晚 6 点微软仍表示在把受影响的服务器送回服务,超过 5 小时。恢复是渐进的:微软称已恢复的服务器保持稳定,并观察到「有限的恢复」。
不等于。Downdetector 统计的是用户主动提交的故障报告数,Outlook 相关报告当日峰值 138,058 起。同一名用户可以重复提交,未提交报告的用户也可能受影响,报告数与受影响用户数不能互换。
微软的表述是:多台服务器意外不可用,把负载压到了剩余基础设施上;这些服务器未能通过自动运行的健康检查。微软把少量近期配置更新列为可能因素,并在测试一项相关变更,尚未给出最终结论,同时表示没有网络攻击的迹象。
Exchange Online 是 Outlook 的邮件服务端,报告集中在邮箱访问。同一天 Microsoft 365 相关的报告在下午 5:47 已回落到接近 13,000 起,Teams 为 763 起,量级明显低于邮箱。
两家公司的人工智能服务通过「连接器」接入 Microsoft 365。OpenAI 称新连接可能断开、工具未按预期工作;Anthropic 称上游提供商的问题影响了它的 Microsoft 365 连接器。两家公司均未说明与微软本次故障的因果关系。
微软列出的可能受影响服务包括 Exchange Online、Teams、SharePoint Online、Copilot、Defender XDR、Defender for Office 365、Intune、Planner、To Do、Purview,以及部分 Power BI 与 Microsoft 365 应用管理中心功能。媒体报道提到部分学区、大学与医院警告通讯受限;Workhorse Group 把三季度财报发布从当日推迟到 11 月 16 日。
不是。据媒体统计,本次是 2026 年内第三次重大 Microsoft 365 中断,前两次分别是 1 月的数小时中断与 8 月一次代码更新引发的故障;此外 10 月还有一次 Azure 中断。
口径说明:① Downdetector 统计的是用户主动提交的故障报告数,不等于受影响用户数。② 时点为美东 11 月 12 日;「超过 5 小时」按事件建立至当日晚间仍在恢复计算。③ 微软对根因的表述是服务器未通过自动健康检查,配置变更仍在排查,非最终结论。④ 两家 AI 公司均未说明与本次故障的因果关系。⑤ 不涉服务水平协议与赔偿,不构成投资判断。




