
 简体中文
 English

AMD 内存减半还剩 95% 性能:省下的 DRAM,变成了闪存和授权费
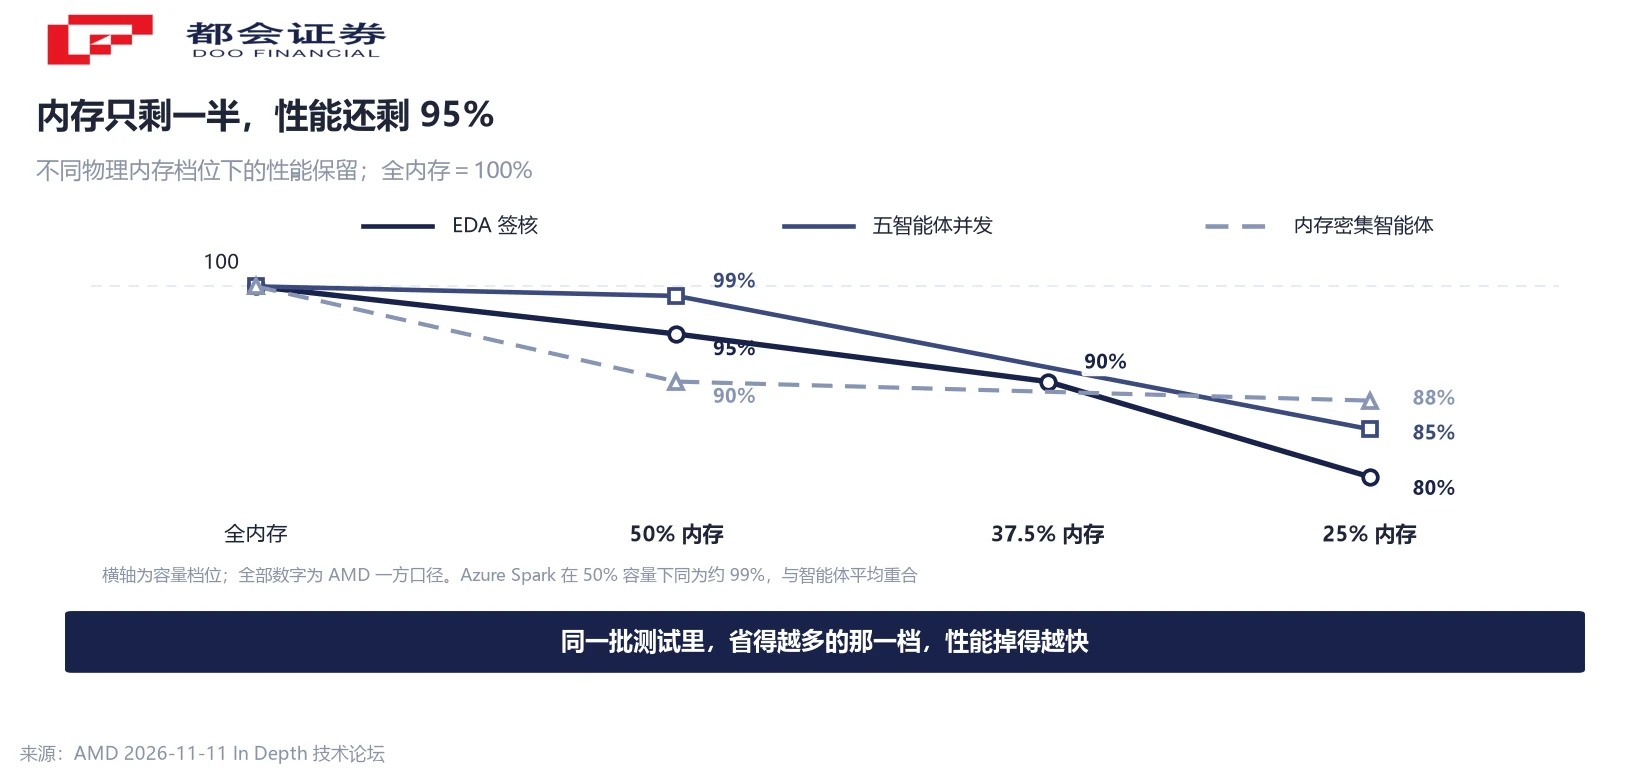
11 月 11 日,AMD 在 In Depth 技术论坛上把 MEXT 的内部账本摊开了。这套软件把不常访问的内存页挪到 NVMe 闪存上,用一组 AI 模型预测哪些页要提前搬回来。AMD 给出的数字是:物理内存砍掉一半,芯片设计软件 Synopsys PrimeTime 还能跑到全配置的约 95%;Azure 上三节点的 Spark 集群,能跑到约 99%。
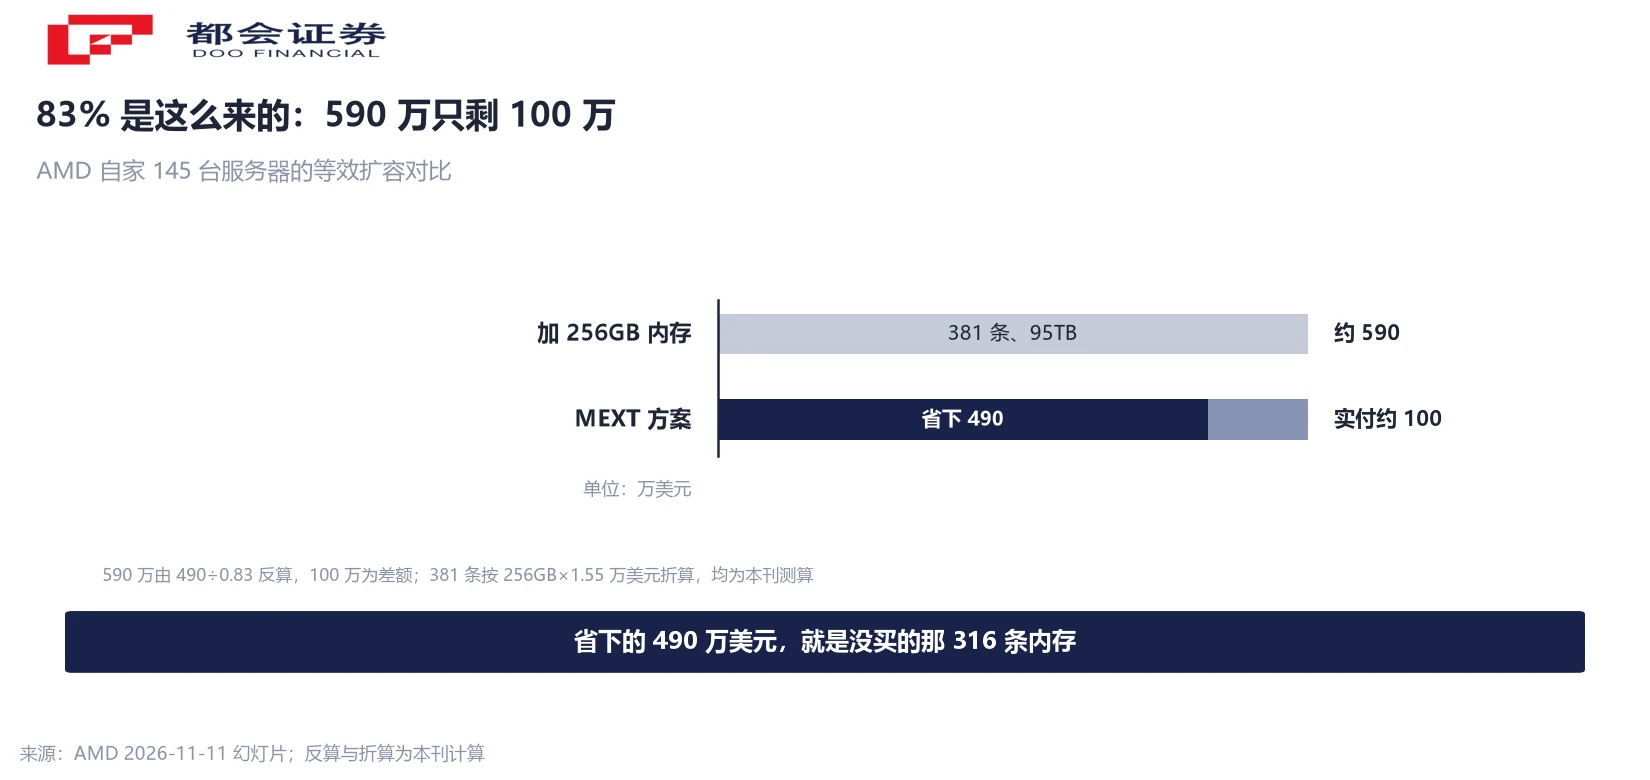
另一组数字更直接。AMD 自己在 145 台服务器上部署了这套东西,按等效内存扩容方案对比,少买了约 490 万美元的 DRAM,扩容成本降低约 83%,并计划明年铺到 2,000 台。
「省下 83% 的内存钱」这句话没有错,但它省的是采购规模,内存需求并没有跟着缩水。少买的那部分换了位置存在——从 DIMM 插槽挪到 SSD 上,从 DRAM 原厂的订单挪到闪存厂和 AMD 的授权单上。
这篇要算的就是这笔搬家账:钱从谁的口袋出来,进了谁的口袋,83% 又有多依赖当下的内存价格。
三组「保留 95%」测的不是同一件事
先把手里的数字分开。AMD 公布的是三组互不相同的测试,样本与规模都不一样,混着谈会得出错误结论。
| 测试 | 负载 | 物理内存 | 性能保留 |
|---|---|---|---|
| PrimeTime | 芯片设计签核 | 50% | 约 95% |
| PrimeTime | 芯片设计签核 | 37.5%(削 62.5%) | 约 90% |
| PrimeTime | 芯片设计签核 | 25%(削 75%) | 约 80% |
| Azure 三节点 | Spark TPC-DS | 50% | 约 99% |
| 五智能体并发 | 几何平均 | 50% | 99% |
| 五智能体并发 | 几何平均 | 25% | 85% |
| 五智能体并发 | 内存密集单任务 | 50% 与 25% | 90% 与 88% |
三组分母不同:PrimeTime 是单机 EDA 作业,Spark 是三节点集群的批量查询,智能体是五个并发任务的几何平均。它们测的都是吞吐或作业完成时间,与单次访问延迟是两回事。
这些全部是 AMD 一方口径:没有测试脚注与工作负载明细,也没有第三方复现。机制不受影响,但「95%」的信任半径会受影响。
它没有让闪存变快,它改的是「哪些页可以不住在内存里」
MEXT 的做法不难讲。操作系统看到的那段内存地址,实际映射到哪里由这套软件决定:热的页留在 DRAM,冷的页卸到 NVMe 盘上,需要时再搬回来。搬的时机由一组 AI 模型预测,主模型是一个基于 transformer 的语言模型,学习每个应用的内存访问顺序;页的存放顺序不影响结果,只要保证页在需要时已经回来。
它的形态很轻:Linux 内核模块;首次训练不到一秒,运行时只占一颗 EPYC 核心,不用 GPU。整套是纯软件,现有 EPYC 服务器也能导入,但要有盘位——HPE 的 MEXT Ready 机型留了 NVMe 位。
关键在延迟差。DRAM 在百纳秒量级,NVMe 闪存在微秒量级,两者差三到四个数量级。MEXT 没有缩小这个差,它把命中率做高,让绝大多数访问落在 DRAM 上;落到闪存的那部分,靠提前搬回把等待藏起来。预测一旦错,代价就直接暴露。
所以它替代的是容量,带宽与延迟没有被替代。判断负载能不能用,只需问:它的内存访问有没有稳定的冷热结构。有,模型学得会;没有,省下的容量就要拿性能去换。
83% 是这么算出来的:等效扩容 590 万美元,实际花了 100 万
AMD 那张幻灯片上有三个数:145 台服务器、避免约 490 万美元的 DRAM 采购、成本降低约 83%。旁边还有一个单价——一条 256GB 的内存 1.55 万美元。
三个数放在一起能反推出整张表。490 万除以 83%,得到等效扩容总额约 590 万美元;590 万减去 490 万,MEXT 这一侧付掉的是约 100 万美元。同样的有效内存容量,加内存条要 590 万,用软件加闪存要 100 万。
换成实物更好懂。一条 256GB 内存 1.55 万美元,折合 60.5 美元一 GB。490 万美元相当于 316 条内存、约 79 TB 容量,摊到 145 台上是每台省 3.38 万美元,约 2.18 条、558GB。等效扩容那 590 万美元对应 381 条、95 TB,每台约 672GB。
看那个 83%:它意味着 MEXT 侧每等效 GB 只花约 10.3 美元,是 DRAM 单价 60.5 美元的 17%。这 17% 里装着闪存、授权和运维,AMD 没拆开。所以「省 83%」说的是总拥有成本,内存本身在系统里照样存在,只是换了介质。
这个 83%,是「一条 256GB 内存卖 1.55 万美元」时的读数
1.55 万美元一条 256GB,折合 60 美元一 GB。这个价格是这轮内存短缺的产物,不是常态,而 83% 跟它绑得很紧。
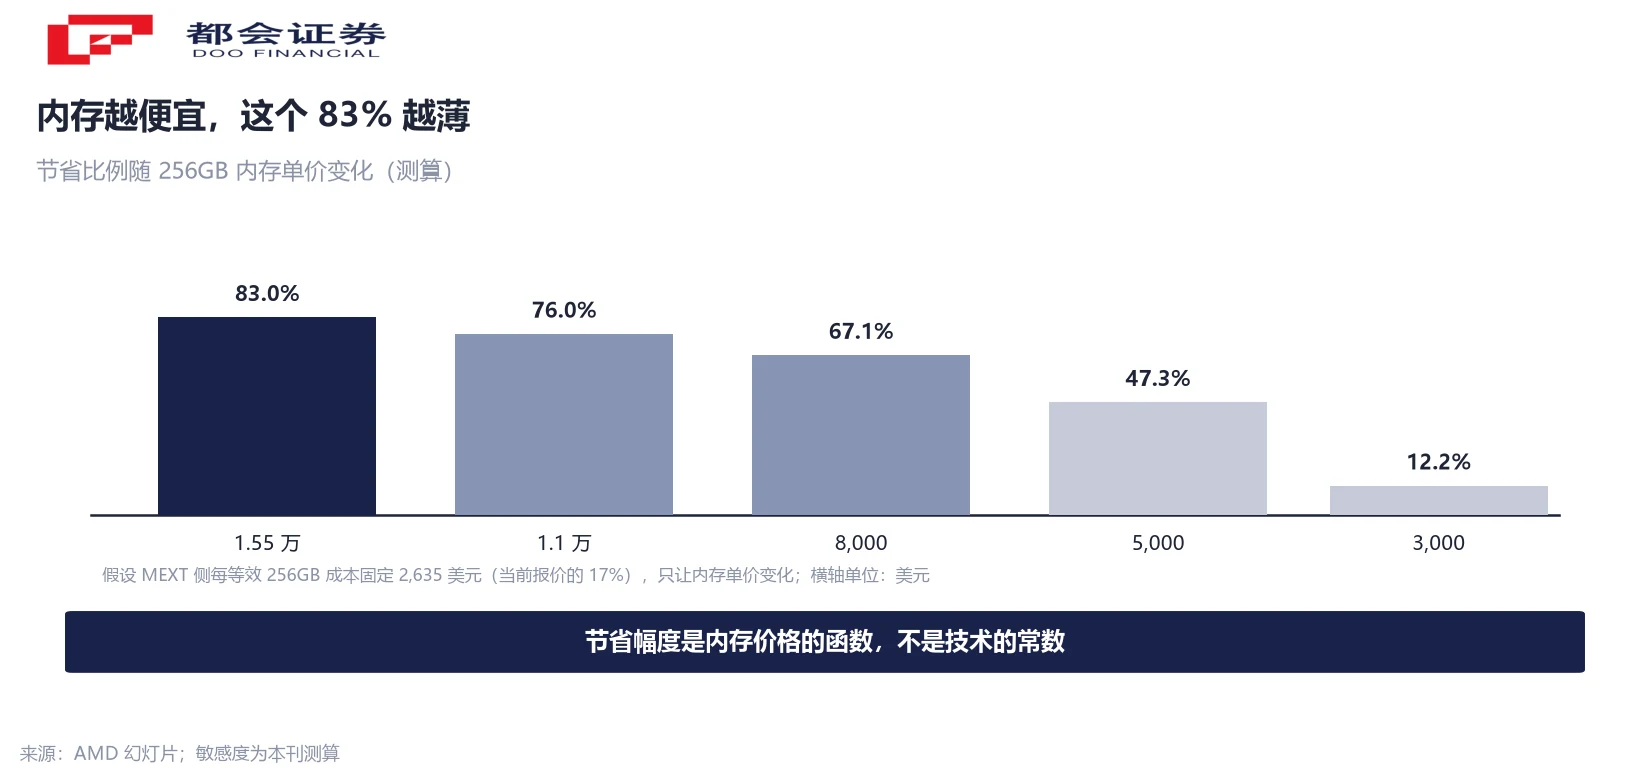
做一个敏感度测算:假设 MEXT 侧成本固定在每等效 256GB 约 2,635 美元(当前报价的 17%,含闪存与授权),只让内存价格变,节省比例这样走。
| 256GB 内存单价 | 折合每 GB | 等效扩容节省 |
|---|---|---|
| 15,500 美元 | 60.5 美元 | 83.0%(AMD 口径) |
| 13,000 美元 | 50.8 美元 | 79.7% |
| 11,000 美元 | 43.0 美元 | 76.0% |
| 8,000 美元 | 31.2 美元 | 67.1% |
| 5,000 美元 | 19.5 美元 | 47.3% |
| 3,000 美元 | 11.7 美元 | 12.2% |
内存若回到 11.7 美元一 GB,只剩 12.2%。
而眼下方向相反。集邦咨询 11 月 4 日的周报说,服务器 DRAM 合约价仍在上涨、各容量 RDIMM 涨幅不一;原厂提高长约比重,用底价与量承诺锁定需求,定价正转向长约导向。
这解释了时点:AMD 挑在内存最贵的窗口推「少买内存」的软件,边际收益最大。省下来的钱里,一部分是技术挣的,另一部分是行情送的,两笔要分开记。
钱没有消失:DRAM 少卖、NAND 多卖、AMD 收授权
省下的 490 万美元落在三个地方。
- DRAM 原厂少卖。145 台上少 316 条 256GB 内存,约 79 TB。按同样比例铺到 2,000 台,约 4,360 条、1.09 PB、6,760 万美元——按现价与现配置比例外推,AMD 没有给 2,000 台的节省指引。
- 闪存与企业级 SSD 多卖。卸下来的页要有地方落,MEXT Ready 机型为此专门保留 NVMe 盘位,第一个合作方是 HPE。省下的 DRAM 钱里,有一块转成了盘的订单。
- AMD 收授权。商业节奏分两段:第一阶段,部分 EPYC Venice 机型带 MEXT Ready 标识;第二阶段才向这些机型发放授权。收入在第二阶段,现在还在铺硬件。
还有第四方,是用它的人。他付的是性能:内存只剩 25% 时,EDA 掉到 80%,智能体几何平均 85%,内存密集的那类 88%。省下的成本有一部分从这里换。
AMD 还标了一组「性能/DRAM 美元」,95 ÷ 50 = 1.90、90 ÷ 37.5 = 2.40、80 ÷ 25 = 3.20、85 ÷ 25 = 3.40,四档与标注完全一致,说明分母就是物理 DRAM 成本占比。对不上的两档都在 50% 容量:99 ÷ 50 应为 1.98 对 1.9,90 ÷ 50 应为 1.80 对 1.7,差 4% 到 6%,取整即可解释。
四处最容易读错的地方
- 内存减半不等于采购减半。能减多少取决于命中率、应用特性与配置策略。AMD 的说法是多数负载可削 20% 至 25%,75% 出现在「越省越专门」的档位。
- 20% 至 25% 与 75% 不是一个数。前者是常态区间,后者是极限档位。只引 75% 会把影响放大三倍。
- EDA 是最适合这项技术的负载之一。PrimeTime 的访问模式规整、可预测,正是页预测模型最容易学的形状。数据库、向量检索、媒体渲染冷热结构完全不同,不能直接套 95%。
- Azure 那个「每小时处理量提高约 40%」是另一回事。等效容量变大,同时排进去的作业变多,单位时间产出自然上升。这是吞吐口径的数,与单个作业跑得更快无关。
还有一条不在 AMD 口径里:闪存也在涨价,2026 年第四季 NAND 合约价预计涨 15% 至 20%。两端同涨时,那 17% 会被闪存侧推高,83% 相应缩水。CFM 闪存市场也提示,这些属特定测试结果,并非所有负载都能达到。
接下来看四个可验证的点
- 2,000 台是否在 2027 年落地。这是这套技术从自家账本变成可复现产品的第一道检验。
- MEXT Ready 授权何时正式发放。授权价格决定那 17% 里 AMD 拿多少,也决定客户的实际节省是否还接近 83%。
- HPE 出货机型的盘位配置与整机价格。闪存配多少、用什么规格,直接改写单位容量的成本。
- 第三方在数据库与向量检索负载上的复现。EDA 与 Spark 都结构规整,这两类才是企业里跑得最多的。
如果 2027 年 2,000 台兑现,且有第三方在数据库负载上复现出「一半容量、九成性能」,「内存需求斜率被削掉一截」这个变量才算进场。此前它只是一份内部账本。
常见问题
一套跑在 Linux 上的内存分层软件。它把不常访问的内存页卸到 NVMe 闪存上,再用一组 AI 模型预测哪些页即将被用到、提前搬回 DRAM。在被卸掉的那部分容量上,操作系统仍然认为内存是装着的,应用不需要改造。AMD 在 2026 年 6 月把这家公司收了下来,此前它在 4 月刚发布自己的产品。
这个数字本身是 AMD 公布的,但要看它的适用条件。99% 出现在 Azure 三节点 Spark 集群和五智能体并发的几何平均两个场景;同一批测试里,内存密集的智能体在 50% 容量下只有 90%,EDA 负载在 25% 容量下是 80%。所有数字都是一方口径,官方没有给测试脚注,也没有第三方复现。
目前还推不出这个结论。已经部署的是 AMD 自家 145 台服务器,2027 年的目标是 2,000 台,规模有限。能减多少也取决于负载:多数负载 20% 至 25%,上限 75% 只出现在专门的场景里。它改变的是内存需求的增速假设,当期供需不受影响。
是三笔钱换了口袋。DRAM 原厂少卖 316 条内存(145 台上),折约 79 TB;闪存与企业级 SSD 接到被卸载的页,HPE 的 MEXT Ready 机型为此留了盘位;AMD 在第二阶段收软件授权。还有一部分成本由用户以性能形式承担。
不会。两者延迟差三到四个数量级,DRAM 在百纳秒量级、NVMe 在微秒量级。MEXT 做的是靠预测把绝大多数访问留在 DRAM,把少量冷页放出去。它替代容量,不替代带宽与延迟。
可以导入,这套东西是纯软件,现有 EPYC 服务器就能用。但需要足够的 NVMe 盘位承载被卸载的页,这正是 MEXT Ready 机型专门留盘位的原因。另外目前它是 EPYC 独占功能。
因为现在内存最贵。一条 256GB 内存报到 1.55 万美元,折合 60.5 美元一 GB,同一套软件在同一批负载上省下的钱达到 83%。内存便宜的时候,这门生意的账算不过来。
EDA 约 80%,五个智能体并发的几何平均 85%,其中内存需求较高的智能体 88%。AMD 的说法是省得越多,适用的应用越专门,性能差距也越明显。
口径说明:① 全部性能数字为 AMD 一方基准,未经第三方复现;② 590 万美元、100 万美元、316 条、79TB、每台 3.38 万美元、10.3 美元/GB 与 2,000 台外推均为本刊按 1.55 万美元/256GB 测算;③ 敏感度表假设 MEXT 侧成本固定、仅移动内存价格;④ 83% 为等效扩容的总拥有成本降幅。




