
 简体中文
 English

一个 AI 需求是怎么传遍整条产业链的?从下单到晶圆,中间隔着 5 个月
本文目录
从应用到芯片:钱先动
链条的起点是需求。企业在软件里用上 AI 功能,用户在终端上调用模型,这些使用行为最终汇聚成模型公司(OpenAI、谷歌、Meta 等)对算力的采购。
这一段的特点是「钱先动」。2026 年全球九大云服务商的资本支出预估约 8300 亿美元,同比增幅从原本的 61% 上调到 79%(TrendForce 2026-05)。仅 Alphabet、亚马逊、微软、Meta 四家,2026 年资本开支总额就预计约 7250 亿美元,比 2025 年的约 4100 亿增长 77%(高盛 2026-05 口径)。
这些钱的第一站是芯片。算力芯片分两类:通用 GPU(英伟达)和定制 ASIC(博通、谷歌 TPU 等)。博通上一财季的 AI 半导体收入达到 167 亿美元、同比增 221%,已经占公司总营收约 56%——一家曾经的多元化半导体公司,现在过半收入来自 AI 这一条线。这条线的进展可以顺着博通的财报前瞻看,通用 GPU 这一侧则可以看英伟达近期的动作。
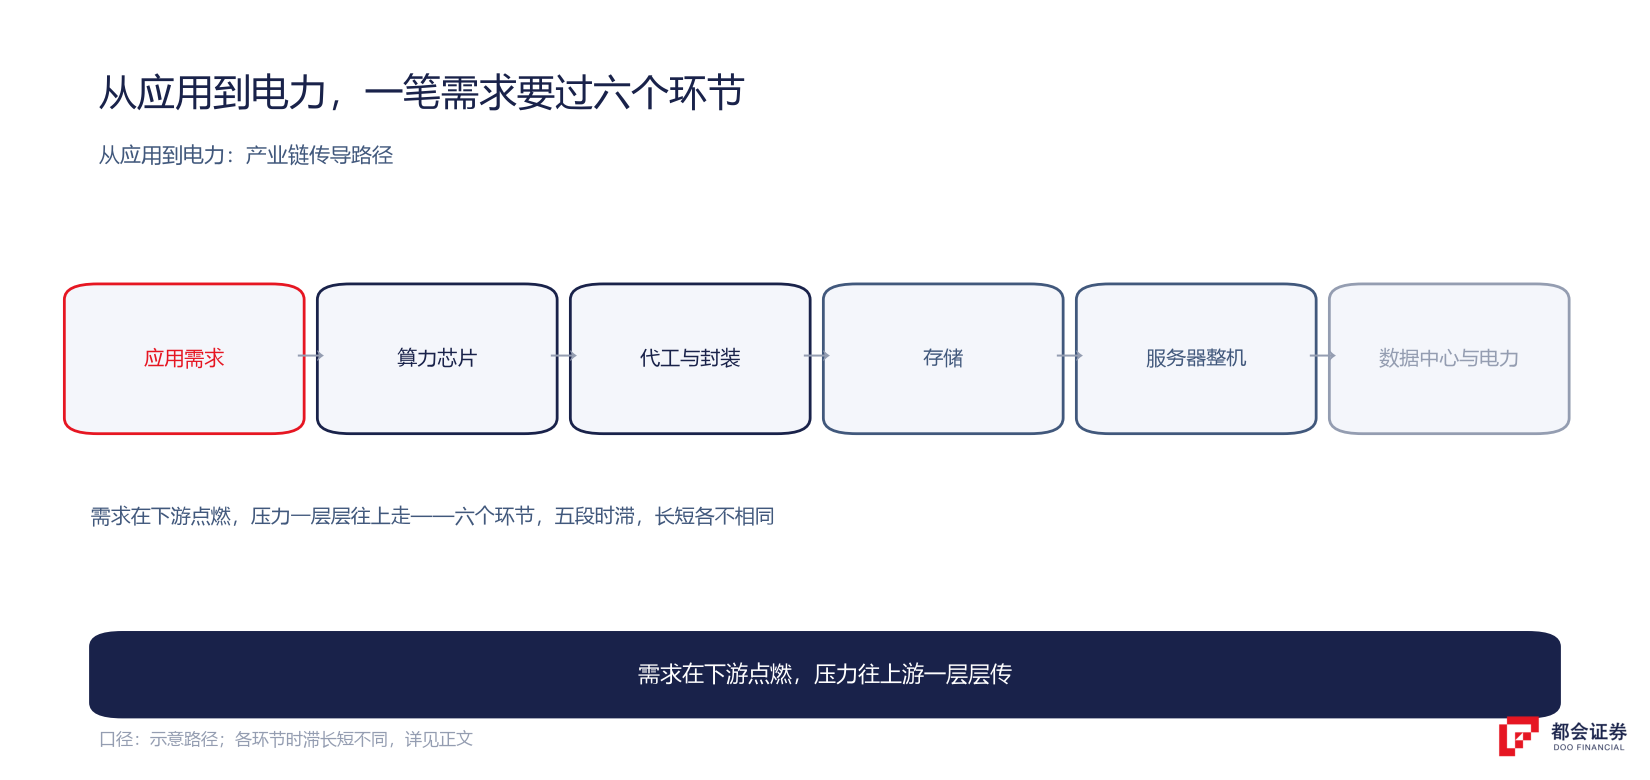
从芯片到制造:卡在代工与封装
芯片设计出来,还要有人能造出来。这一段是整条链上壁垒最集中的地方。
先进制程的产能高度集中在台积电手里;而 AI 芯片特有的 CoWoS 先进封装,更是决定芯片能否量产的关键一环——它负责把 GPU 和 HBM 内存封装在一起。设计能力再强,封装排不上队,芯片也出不了货。
这一段卡住的后果是「设计等制造」:芯片公司能拿到订单,但交付节奏取决于代工和封装的产能爬坡。设计、制程、封装、客户绑定、全球布局这几层叠加起来,构成了很深的壁垒——台积电的五层壁垒,我们在专稿里有完整拆解。
从制造到存储:内存成了最紧的一环
再往下走,会碰到这一轮最紧的一环:存储。
一台 AI 服务器里,GPU 之外最贵的部件就是内存。高带宽内存(HBM)负责喂数据给 GPU,服务器 DRAM 负责承载模型和中间结果。当算力需求爆发时,内存就成了约束条件。
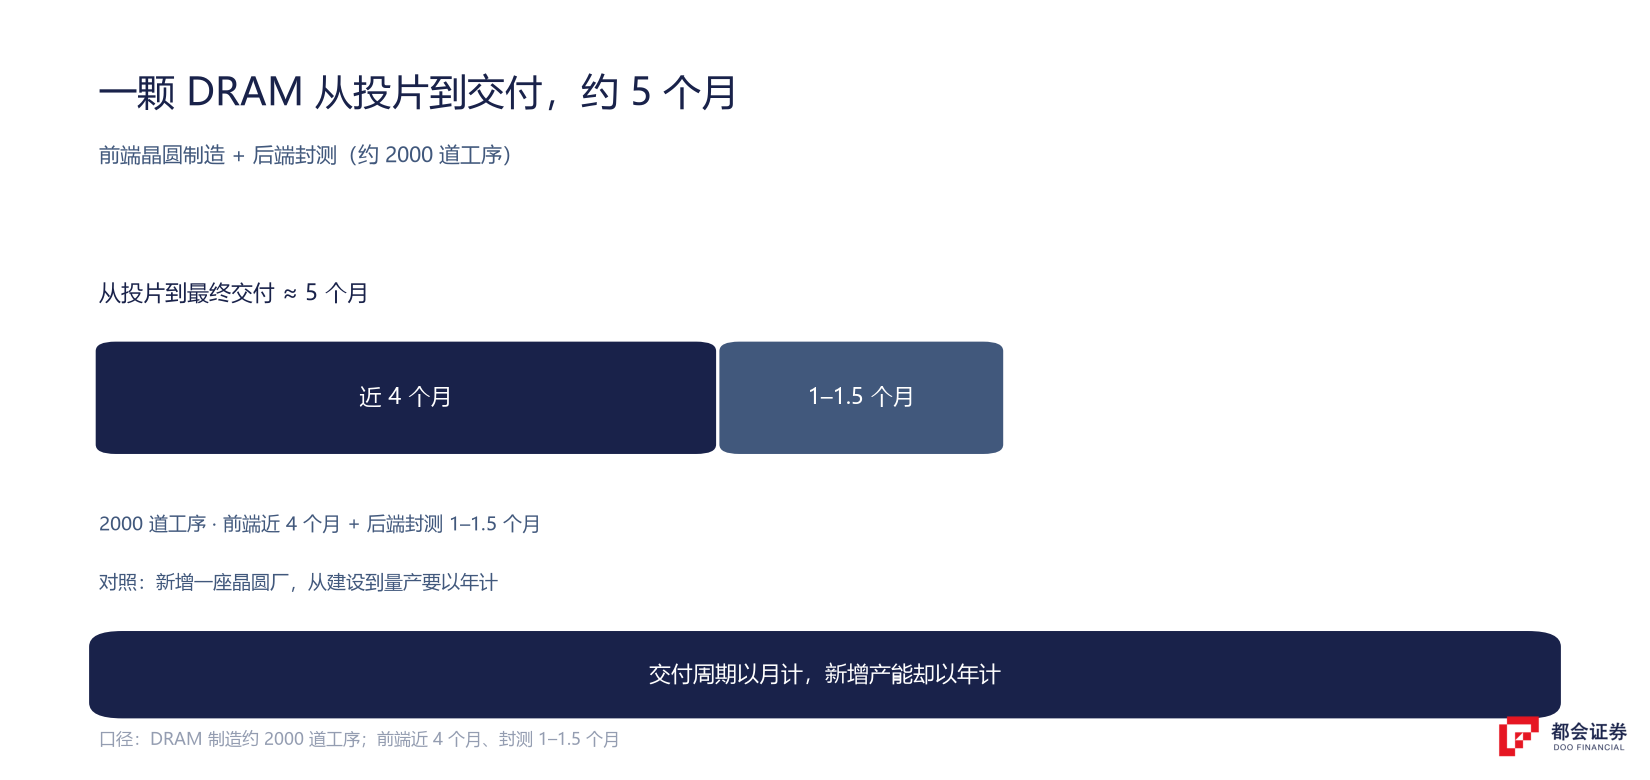
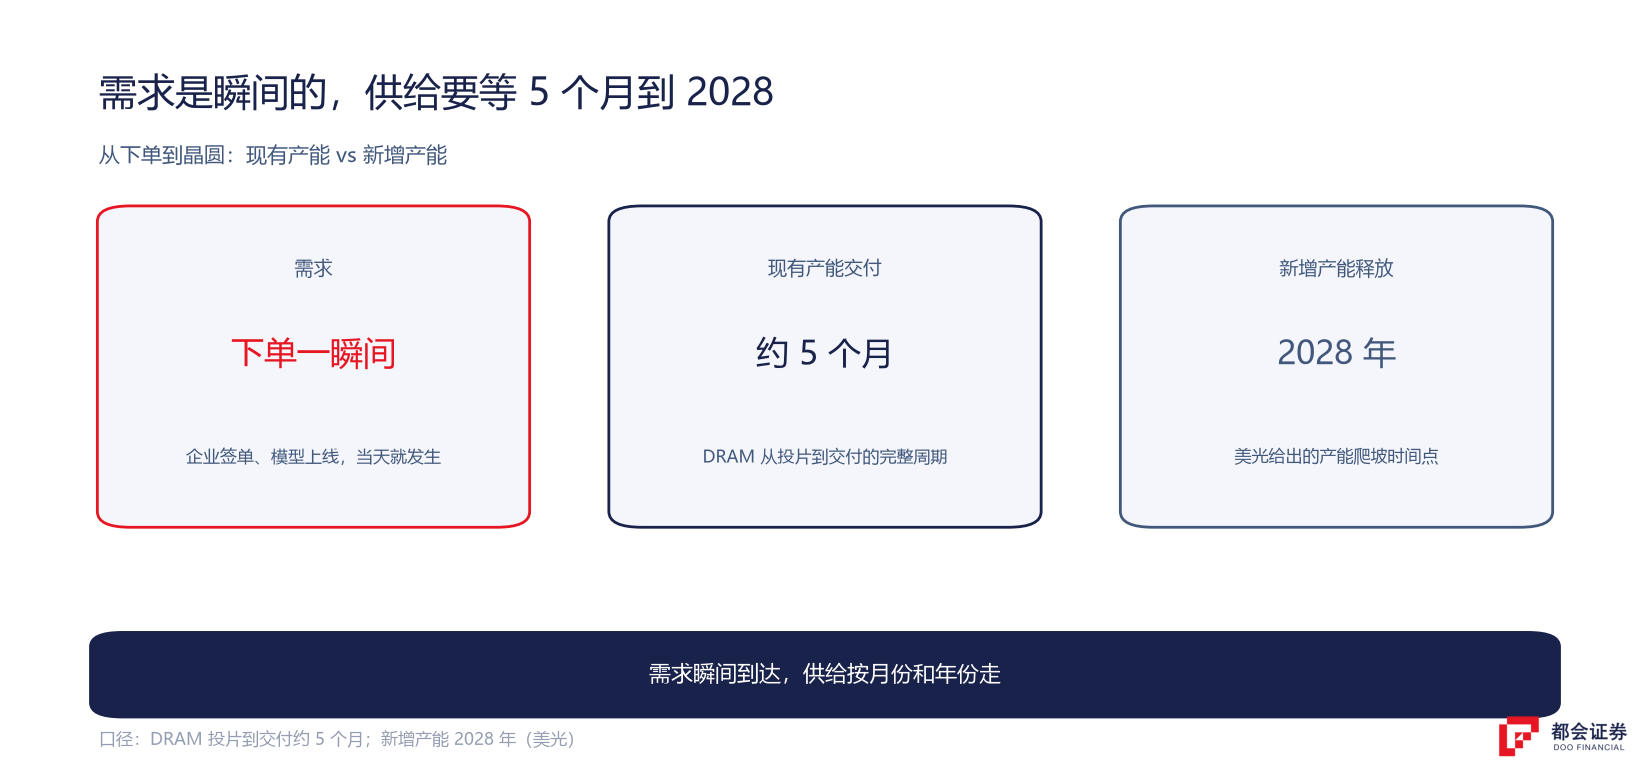
这个瓶颈的时滞最长。美光管理层给出的判断是:当前内存短缺覆盖所有市场领域,有意义的新增供应要到 2028 年才开始爬坡——同期资本开支已经推高到 2027 财年可能超过 450 亿美元的量级。「5 个月」和「2028 年」的差别,正是理解这条链的关键:前者是现有产能的交付周期,后者是新增产能的建设周期。市场看到的订单爆发,落到供给上,中间隔着整个建设周期。美光在这条链上的位置,可以先看这份公司研究。
从零件到整机:服务器在中段转手
内存、GPU、网络芯片到齐,才轮到整机厂把它们组装成可以部署的服务器。
戴尔、超微这类公司处在这个位置。它们的特点是贴近需求、但毛利率不高——本质是把上游的芯片集成成客户能直接用的整机。戴尔上一份财报里,AI 服务器订单达到 609 亿美元、积压订单 950 亿美元;管理层被问到交付约束时,副董事长兼首席运营官杰夫·克拉克连说了三遍「DRAM、DRAM、DRAM」,再补上「NAND、NAND、NAND」。
这句话本身就是一个传导信号:整机厂排在链条中段,它比芯片厂更早感受到需求,也比芯片厂更早碰到上游的供应限制。戴尔这一季的订单与瓶颈,可以看这份财报解读。
从机柜到电力:最后也是最慢的一环
服务器进了数据中心,还有一环经常被忽略——电。
一座 AI 数据中心不只是「放服务器的地方」,它需要变电、配电、冷却,以及持续的电力供应。甲骨文一个季度就新增了 850 兆瓦的数据中心容量,同时向客户交付超过 30 万颗 GPU——这两个数字背后,是对电网和发电能力的真实压力。
这也解释了为什么 AI 需求会传导到看起来不相关的板块:电力设备、燃气轮机、核电、变压器——它们不生产芯片,但它们决定了芯片能不能被通电。当上游的芯片与内存逐步跟上,这一环会变成新的约束。
走完整条链,有三条规律
把整条链走一遍,可以归纳出三条规律。
应用层几周就能调整,芯片交付以季度计,晶圆制造约 5 个月,新建产能以年计(美光的 ID1 在 2027 年中、ID2 在 2028 年末、纽约首厂 2030 年)。越往上游,越慢。
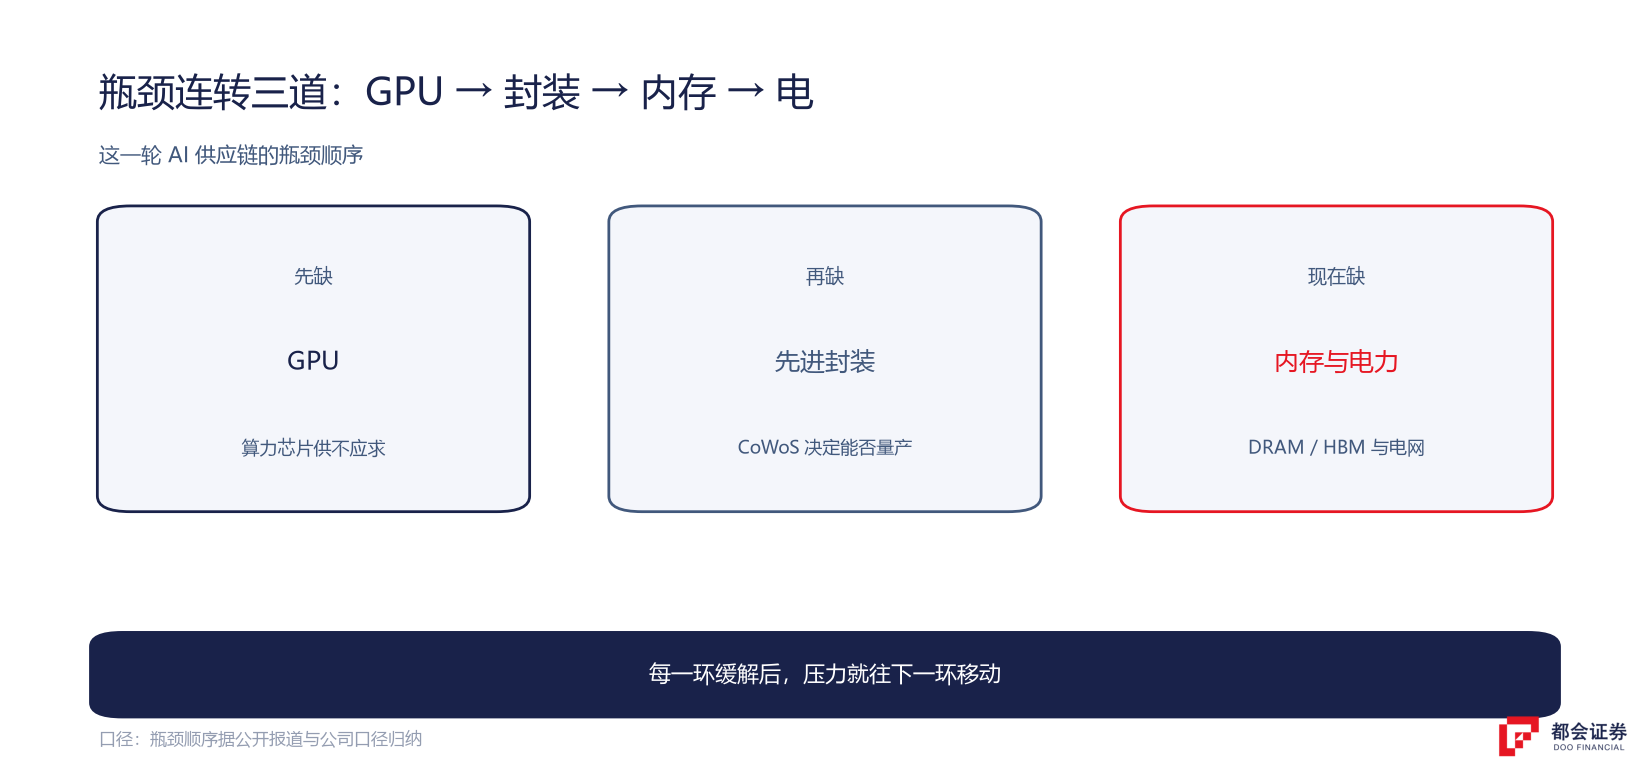
这一轮的顺序是:先缺 GPU,再缺封装,然后缺内存,现在开始缺电。每一环缓解之后,压力会往下一环移动——所以盯着「当前最缺什么」,比盯着「总需求有多大」更能判断产业链的紧张程度。
同样的需求,落在不同环节,结果是几十个点的毛利率差异——这取决于各环节的供给弹性和议价能力。这一点我们在《AI 资本开支的钱最终流向哪里》一篇里单独展开。
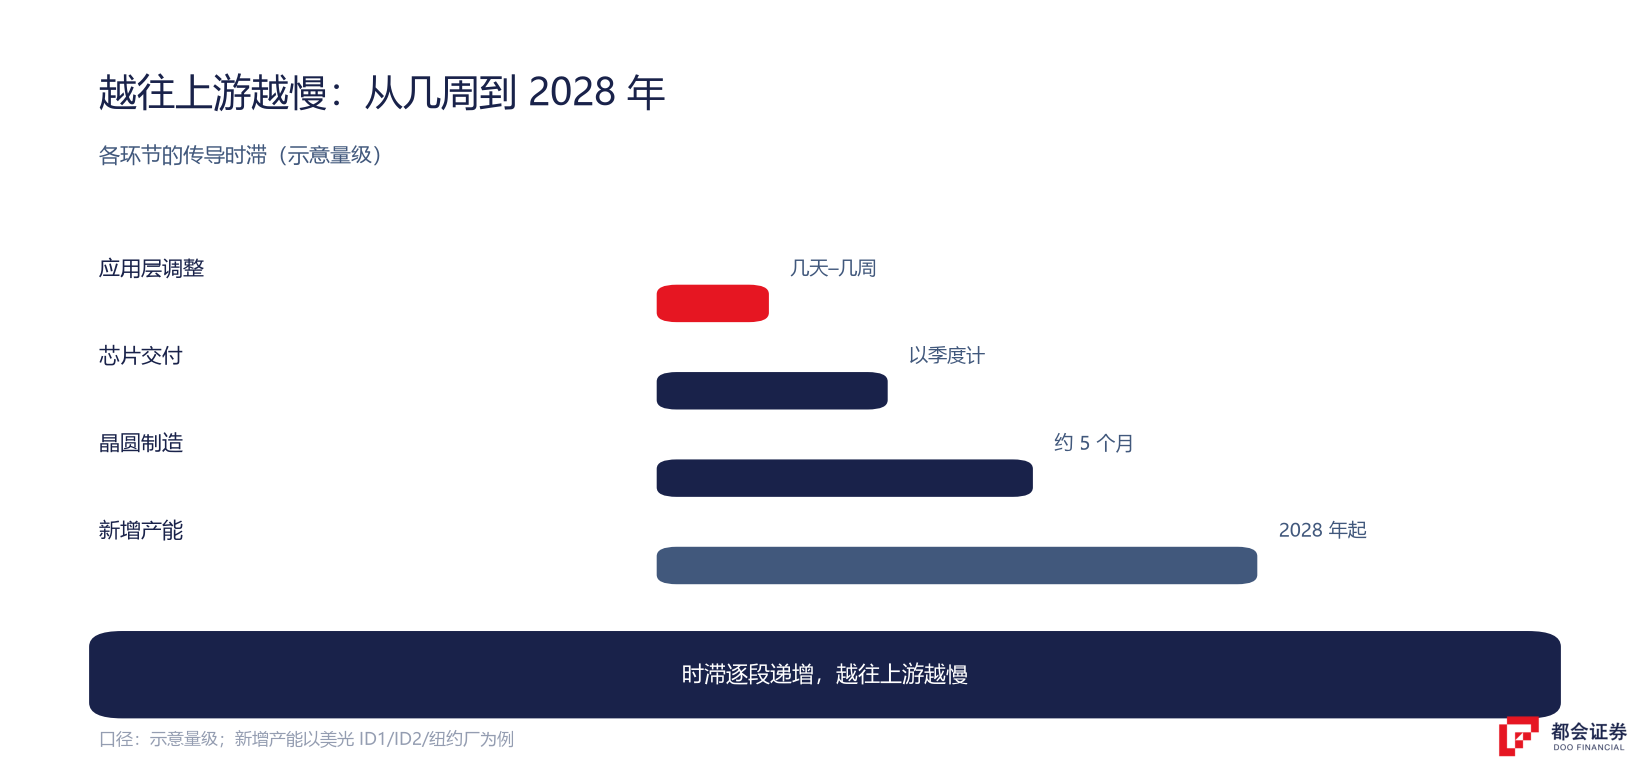
三条规律合起来,给了一张定位图:任何一个时点,你都能判断需求走到了哪一环、当前卡在哪一环、以及利润正在流向谁。这比笼统地问「需求好不好」,更能解释产业链上为什么有的环节紧、有的环节松。从这个角度看,半导体各环节的市场地位也是一张可以对着看的图。
该盯什么:三个问题
与其预测拐点,不如盯三个能反映产业链松紧的问题。
瓶颈的位置决定了利润流向,也决定了哪些公司的议价能力在上升。
比如 DRAM 的交付周期是否缩短、新增产能的时点是否提前。时滞缩短,意味着供给正在追上需求。
链条再长,起点还是「有没有人真的在用 AI 并为此付钱」。上游所有环节的景气,最终都要回到这一个问题上。
这三个问题,落到具体公司身上,还是要回到财报与现金流。研究一家美股公司的基本方法,可以帮你把产业链的宏观判断,落到一家公司的真实数据上。
常见问题
因为两者的节奏完全不同。需求端可以当天转向:一家企业签下一批 AI 服务器订单,或一个模型上线,需求马上发生。而供给端要经过设计、制造、封装、测试、交付一长串工序,每一步都有自己的时滞,越往上游越慢。以 DRAM 为例,从投片到最终交付约需 5 个月;如果要等一座新晶圆厂投产,则要以年计——美光给出的新增供应时间点是 2028 年。链条再长,起点还是需求,但这个需求要点燃整条产业链,需要等待。
按美光的口径,一颗 DRAM 从投片到最终交付,全程约 2000 道工序、大约 5 个月。其中前端晶圆制造接近 4 个月,后端封装测试再花 1 到 1.5 个月。这个 5 个月,说的是现有产能的交付周期——产线已经在运转,只是把一批晶圆做出来、测好、交付,就要这么久。它和「新增产能的建设周期」是两个概念,不要混为一谈。
因为建产能不是加一条产线那么简单。一座晶圆厂要先建设厂房、安装设备、调试工艺、把良率爬上来,整个过程要以年计。美光管理层给出的判断是:当前内存短缺覆盖所有市场领域,有意义的新增供应要到 2028 年才开始爬坡。它的新产线时点也印证了这一点——ID1 预计 2027 年中、ID2 在 2028 年末、纽约首厂要到 2030 年。所以「5 个月」和「2028 年」的差别,正是现有产能与新增产能的差别。
因为每一环缓解之后,压力会往下一环移动。这一轮的顺序大致是:先缺 GPU,再缺先进封装(CoWoS 决定芯片能否量产),然后缺内存(DRAM、HBM 供需紧张),现在开始缺电。当芯片的产能逐步跟上,数据中心的电力、变电、冷却这些「看不见的环节」就成了新的约束。甲骨文一个季度就新增了 850 兆瓦的数据中心容量、向客户交付超过 30 万颗 GPU,这两个数字背后,是对电网和发电能力的真实压力。
看三个问题。一是当前瓶颈在哪一环——瓶颈的位置决定了利润流向,也决定了谁在议价。二是关键环节的时滞有没有变化,比如 DRAM 的交付周期是否缩短、新增产能的时点是否提前;时滞缩短意味着供给正在追上需求。三是最终需求有没有变化——链条再长,起点还是「有没有人真的在用 AI 并为此付钱」,上游所有环节的景气,最终都要回到这一个问题上。
口径说明:时滞为示意量级;产能时点属公司规划;机构预测属预期。


