
 简体中文
 English

份额第三,利润第一:美光如何在 HBM 三国杀中飙出 85% 毛利率
本文目录
两个事业群,半年翻倍:美光的 AI 数据中心版图
美光自 FY2025 起把业务重组为四个事业群。与 AI 数据中心直接相关的是两个:CMBU(Cloud Memory,云内存)和 CDBU(Core Data Center,核心数据中心)。CMBU 装的是 HBM、高容量 DIMM 和 LPDRAM——AI 加速器和服务器的核心内存;CDBU 则覆盖数据中心 DRAM 与 NAND SSD。
FY2025,CMBU 营收 135.24 亿美元、占总营收 36%,同比增长 257%,运营利润率从 FY2024 的 6% 升到 45%;CDBU 营收 72.29 亿美元、同比增长 45%,运营利润率从 5% 升到 30%。两个单元合计约 207.5 亿美元,占全公司 56%。
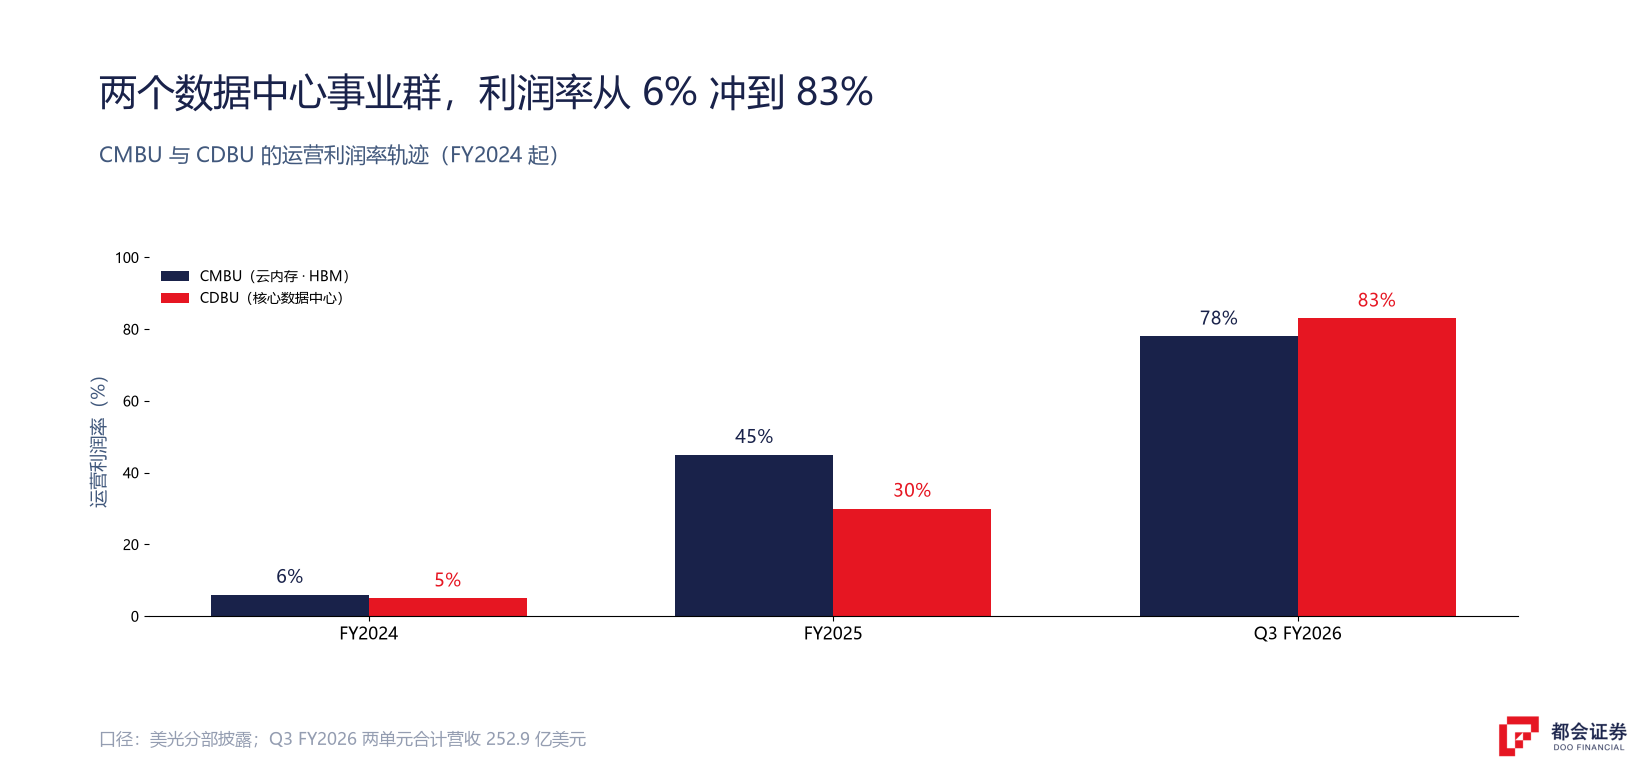
到 Q3 FY2026(截至 2026 年 5 月 28 日),这一比例升到约 61%:CMBU 单季营收 137.69 亿美元、CDBU 115.24 亿美元,合计 252.9 亿美元——单季度就已经超过 FY2025 全年两个单元的总和。运营利润率也一起抬升:CMBU 到 78%,CDBU 到 83%。
有一个容易看错的地方:HBM 在美光的组织架构里归 CMBU,不归 CDBU。所以看这块业务时,别把 CMBU 直接读成「HBM 单元」——它同时包含了高容量 DIMM 和 LPDRAM。
ASP 暴涨、出货几乎没动:HBM 如何挤干 DRAM 供给
DRAM 是美光营收的绝对主力。Q3 FY2026,DRAM 营收 313.28 亿美元、占总营收 75.6%,同比增长约 346%。但比绝对值更值得看的,是增长由什么驱动。
| 季度 | DRAM 营收 | 占总营收 | 同比增长 | ASP 环比 | Bit 出货环比 |
|---|---|---|---|---|---|
| Q4 FY2025 | 约 90 亿美元 | 约 80% | +69% | — | — |
| Q1 FY2026 | 108 亿美元 | 79% | +69% | +20% | 微增 |
| Q2 FY2026 | 188 亿美元 | 79% | +207% | +60% 上下 | 低个位数 |
| Q3 FY2026 | 313 亿美元 | 76% | +343% | +60% 上下 | 低个位数 |
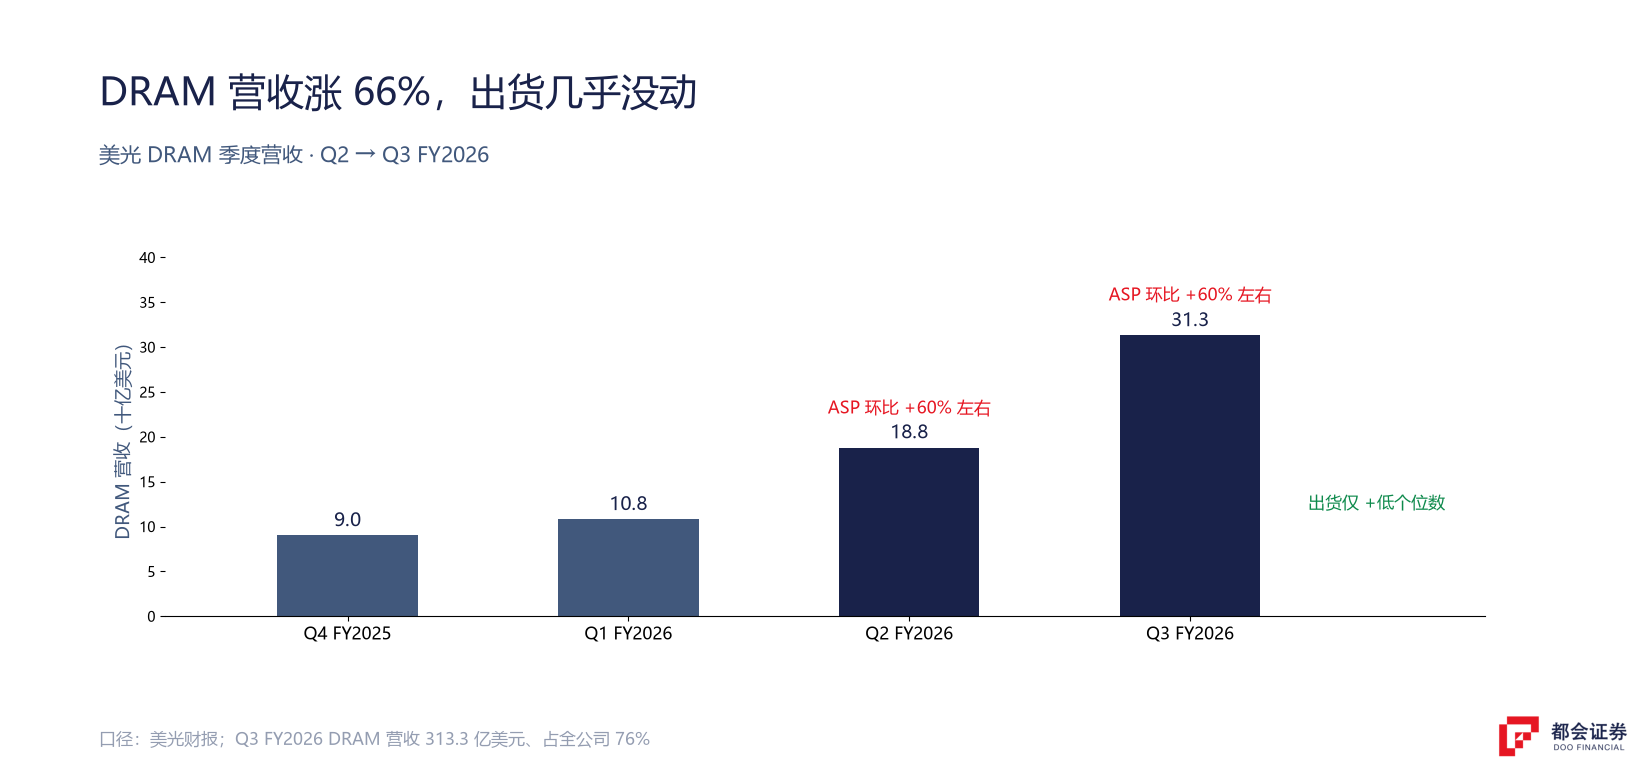
Q3 环比 ASP 涨约 60%,bit 出货只增低个位数。这意味着 DRAM 营收的增长几乎全部来自价格上涨,而不是产能扩张。背后的传导链条是:AI 需求推高 HBM 出货,HBM 的贸易比(生产 HBM 占用的晶圆面积相对标准 DRAM 的倍数)随之上升,可用于标准 DRAM 的晶圆面积被挤压,全线 DRAM 供应趋紧,价格全面上涨。
换句话说,每多生产一个 HBM 堆栈,就少一块晶圆能做标准 DRAM。HBM 的高附加值不只在它自己的售价上,还通过收紧非 HBM DRAM 的供给,把整条 DRAM 产品线的定价权一起抬了起来。
HBM 自身的贡献同样亮眼。Q3 FY2026 HBM4 营收已超过 10 亿美元;HBM3E 与 HBM4 的产能已被订满到 2027 日历年,需求延伸到 2028 年。管理层在电话会上把 HBM 的市场规模目标上修到 2027 年突破 1,000 亿美元,比此前预期提前一年。第三方机构的口径则更保守:TrendForce 预计 2026 年 HBM 市场约 550 亿美元,Gartner 更乐观,预计 2026 年约 792 亿美元。
Q3 营收翻倍:被市场忽视的 SSD 暗线
如果说 HBM 是美光 AI 叙事的主角,那么数据中心 SSD 就是被低估的第二条增长曲线。
| 季度 | NAND 营收 | 占总营收 | 同比增长 | ASP 环比 | Bit 出货环比 |
|---|---|---|---|---|---|
| Q4 FY2025 | 约 23 亿美元 | 约 20% | −5% | — | — |
| Q1 FY2026 | 27 亿美元 | 20% | +22% | 小幅下降 | 高 20% 段 |
| Q2 FY2026 | 50 亿美元 | 21% | +169% | +70% 以上 | 低个位数 |
| Q3 FY2026 | 99 亿美元 | 24% | +361% | +80% 以上 | 中个位数 |
Q3 FY2026 NAND 营收环比增长 99%、同比 361%,和 DRAM 一样主要由价格驱动(环比 ASP 涨 80% 以上,bit 出货只增中个位数)。更关键的是,Q3 数据中心 SSD 营收超过 50 亿美元、环比翻倍以上。
这反映的是 AI 工作负载对持久化存储的新需求。大模型推理需要快速访问海量上下文数据,SSD 成为 GPU 与 HDD 之间的关键存储层级;AI 数据中心正用 SSD 大规模替代传统机械硬盘来满足吞吐量要求。而智能体(Agentic AI)的兴起,又把存储需求从 GPU 机架扩展到 CPU 机架和存储机架——每个智能体的长对话上下文都要落地存储。
CDBU 的毛利率轨迹也说明了这一点:从 Q4 FY2025 的 41% 升到 Q3 FY2026 的 87%,46 个百分点的改善幅度甚至超过 CMBU。这背后是 NAND SSD 与数据中心 DRAM 的双重涨价,叠加制造良率改善。
带宽 2.3 倍、功耗降两成:HBM4 改了什么
HBM4 相对 HBM3E 的提升不止是数字翻倍,它是 AI 内存架构的一次代际跃迁。
| 规格 | HBM3E | HBM4(12-high) | 变化 |
|---|---|---|---|
| 单堆栈带宽 | >1.2 TB/s | >2.8 TB/s | 约 2.3 倍 |
| 总线宽度 | 1024-bit | 2048-bit | 翻倍 |
| 引脚速率 | 约 9.2 Gbps | >11.0 Gbps | 约 +20% |
| 单堆栈容量 | 36GB(12H) | 36GB(12H) | 持平 |
| 16-high 容量 | — | 48GB(16H) | 新增 |
| 功耗效率 | 基准 | >20% 改善 | >20% |
| DRAM 制程 | 1β | 1β / 1γ | 代际升级 |
带宽翻倍的核心路径是总线宽度从 1024-bit 翻到 2048-bit,而不是单纯提高引脚速率。引脚速率从约 9.2 Gbps 提到 11.0+ Gbps,只增长约 20%;总线翻倍才把总带宽拉到 2.3 倍。这个选择的意义在于:AI 加速器封装里功耗预算是硬约束,靠加宽总线而不是拉高频率来提带宽,能在不明显增加功耗的前提下把带宽做上去。美光官方数据显示,HBM4 在相同速率下功耗效率改善超过 20%(以 pJ/bit 衡量)。
容量上,HBM4 16-high 把单堆栈容量提到 48GB,已于 2026 年向客户出样。下一代 HBM4E 将采用美光的 1γ DRAM 制程,计划 2027 日历年量产。值得一提的是爬坡节奏:美光 HBM4 12-high 的量产爬坡速度约为上一代 HBM3E 的 2 倍——这意味着学习曲线更陡,后续产能释放可能更快。
份额第三、利润第一:HBM 三国杀的反直觉真相
HBM 市场只有三家供应商:SK 海力士、美光和三星。三家的份额正在发生微妙变化。
| 时间节点 | SK 海力士 | 三星 | 美光 |
|---|---|---|---|
| 2025 Q2(营收份额) | 64% | 15% | 21% |
| 2026 Q1(营收份额) | 58% | 21% | 21% |
| 2026 Q2(营收份额) | 50% | 33% | 18% |
数据来自 Counterpoint Research(按营收计)。SK 海力士仍是无可争议的领导者,但份额从 2025 Q2 的 64% 降到 2026 Q2 的 50%;三星复苏最快,一年间从 15% 升到 33%;美光从 21% 小幅回落到 18%,仍是第三。
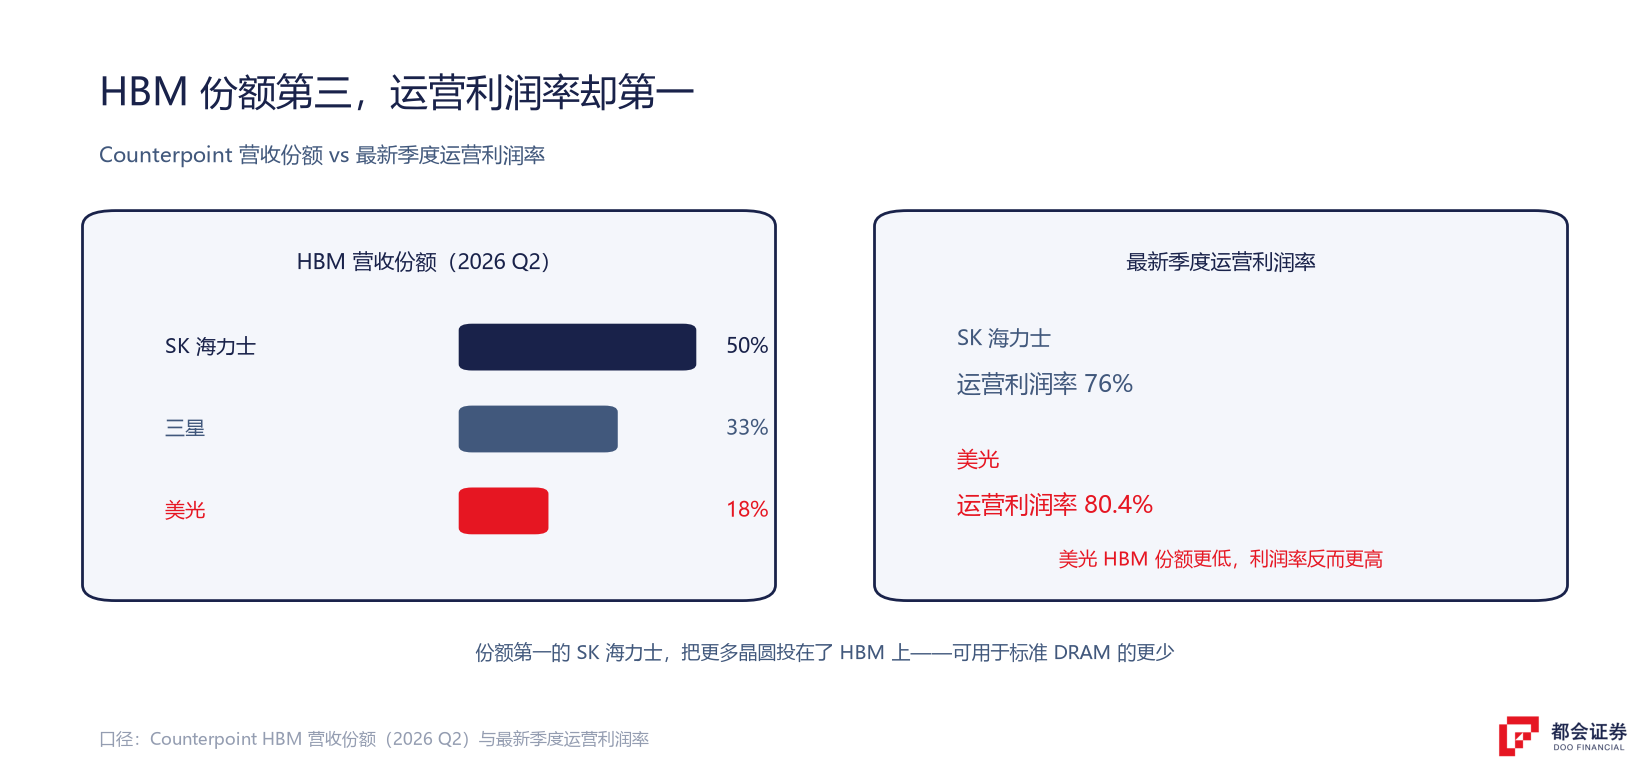
美光份额的小幅回落并不是出货减少——它的整体 DRAM 营收环比增速约 66%,是三家中最快的。份额下滑的主要原因是三星 HBM4 量产爬坡抢占了部分新增需求。
更值得注意的,是份额与利润的倒挂。美光最新季度整体毛利率 84.9%、运营利润率 80.4%,已经超过 SK 海力士的 76% 运营利润率。原因有三层:美光 DRAM 占比更高(约 76%)、HBM3E/HBM4 有 ASP 溢价,以及非 HBM DRAM 在供应紧张下的定价权。
| 指标 | SK 海力士 | 美光 |
|---|---|---|
| 最新季度总营收 | 约 590 亿美元 | 414.6 亿美元(Q3 FY2026) |
| 整体运营利润率 | 76% | 80.4%(Q3 FY2026) |
| DRAM 营收环比增速 | 37.9% | 约 66% |
而 SK 海力士的市场领导地位,反而成了一种负担。它的 DRAM 营收环比增速只有 37.9%,远低于美光(约 66%)和三星(63.4%)——因为大量晶圆产能被 HBM 占用,限制了标准 DRAM 的出货增长。HBM 份额越高,可用于标准 DRAM 的晶圆越少,这个挤占效应对 SK 海力士的影响最重。
不过,HBM4 这一代的竞争还没分出胜负。英伟达已把美光、SK 海力士、三星三家都纳入了 Vera Rubin 平台的 HBM4 认证;据韩联社报道,SK 海力士拿到了该平台约 70% 的 HBM4 订单,高于市场此前约 50% 的预期。Counterpoint 预计 2026 年 HBM4 市场份额为 SK 海力士 54%、三星 28%、美光 18%。
美光另有一条别人没披露的优势:16 份战略客户协议(SCA),锁定约 1,000 亿美元收入至 2030 年,并另计约 220 亿美元客户预付款。管理层称这些协议覆盖了约 20% 的 DRAM 产量和约三分之一的 NAND 产量——这种长期锁定是 SK 海力士和三星目前没有披露的差异化优势。
算力涨 3 倍,带宽不涨会怎样:Vera Rubin 的内存墙
英伟达在 GTC 上发布的 Vera Rubin 平台是 Blackwell 的下一代架构。它必须用 HBM4,由三个约束决定,其中最核心的是「内存墙」。
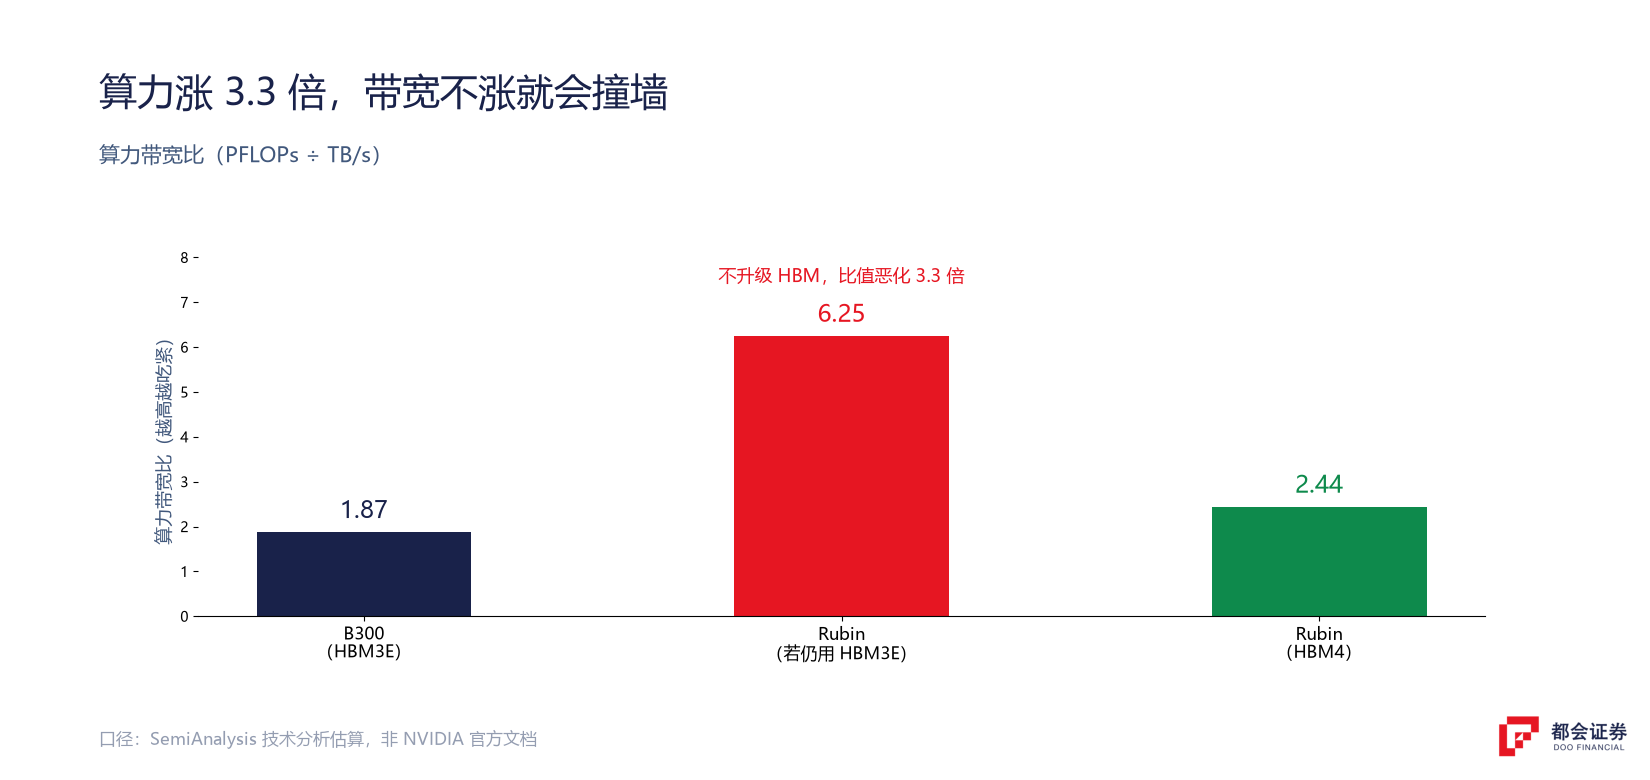
据 SemiAnalysis 基于公开演示的技术分析,Vera Rubin 的 FP4 稠密算力达到 50 PFLOPs,是 B300(约 15 PFLOPs)的 3 倍以上;但 GPU 算力的增速远快于内存带宽。B300 用 HBM3E 提供 8 TB/s 总带宽,算力带宽比约 1.87 PFLOPs/(TB/s);如果 Rubin 沿用 HBM3E,这一比值会恶化到 6.25,意味着 GPU 大量时间在等数据而不是在算。换用 HBM4 后,总带宽提到 20.5 TB/s,比值回落到 2.44——虽然仍高于 B300,但比不升级好得多。
第二个约束是推理场景的 KV Cache。大模型推理——尤其是长序列和智能体工作流——需要大量 KV Cache 存储,HBM 容量直接决定能服务的并发请求数和上下文长度。美光 HBM4 12-high 提供每堆栈 36GB,8 堆栈正好 288GB,与 Vera Rubin 的规格精确匹配。
第三个是功耗。据该分析,Rubin 的 TDP 估计约 1,800W,比 B300 的约 1,200W 增加 50%。在功耗预算已经很紧的情况下,HBM 要在提供 2.3 倍带宽的同时控制功耗增长——HBM4 超过 20% 的功耗效率改善,让 20.5 TB/s 在功耗上成为可行方案。
再下一代是 Rubin Ultra:HBM 堆栈数从 8 翻倍到 16,采用 HBM4E 16 层堆栈,单封装容量达到 1,024GB。这对应的正是美光 HBM4E 路线图里的 1γ 制程与 2027 日历年量产目标。
GPU 旁的隐形战场:HBM、DRAM 与 SSD 各管什么
AI 数据中心的存储不是单一品类,而是按延时和带宽需求形成的层级结构。
| 层级 | 产品 | 在 AI 里的角色 | 延时 | 带宽 |
|---|---|---|---|---|
| HBM(GPU 封装内) | HBM3E / HBM4 | 训练:权重、激活、梯度;推理:权重、KV Cache | 约 100ns | >1.2–2.8 TB/s/堆栈 |
| 服务器 DRAM | DDR5 RDIMM / LPDDR5X | 训练:数据预处理;推理:模型加载与上下文 | 约 80–100ns | 约 100–200 GB/s |
| 数据中心 SSD | 9650 / 6600 ION | 训练:数据集与检查点;推理:参数与上下文 | 约 20–100µs | 14–28 GB/s |
HBM 在训练里承载模型权重、激活值和梯度,在推理里承载权重和 KV Cache。推理对带宽的需求甚至高于训练——自回归生成要反复读取权重,而 KV Cache 随序列长度线性增长,所以带宽提升会直接变成推理吞吐量的提升。
数据中心 SSD 则在训练和推理里扮演不同角色。美光 9650 采用 PCIe Gen6 接口和 G9 TLC NAND,定位训练流水线的高性能存储层,顺序读取约 28 GB/s、随机读取约 550 万 IOPS,顺序写入 14 GB/s 支持快速保存检查点。美光 6600 ION 采用 PCIe Gen5 和 G9 QLC NAND,定位推理、RAG 上下文存储与硬盘替代的高密度方案,单盘容量最高 245.76TB。
| 产品 | 接口 | NAND | 顺序读 | 最大容量 | 定位 |
|---|---|---|---|---|---|
| 9650 | PCIe Gen6 | G9 TLC | 约 28 GB/s | — | 性能层:GPU 数据供给、检查点 |
| 6600 ION | PCIe Gen5 | G9 QLC | 约 14 GB/s | 245.76TB | 容量层:上下文存储、硬盘替代 |
拆解 40 个百分点:毛利率改善从哪来
美光这一轮的毛利率改善,放在存储行业历史上也属罕见。
| 季度 | 营收 | 非 GAAP 毛利率 | 环比变动 | GAAP 毛利率 |
|---|---|---|---|---|
| Q4 FY2025 | 113.2 亿美元 | 45.7% | — | 38.4% |
| Q1 FY2026 | 136.4 亿美元 | 56.8% | +11.1pp | 56.0% |
| Q2 FY2026 | 238.6 亿美元 | 74.9% | +18.1pp | 74.4% |
| Q3 FY2026 | 414.6 亿美元 | 84.9% | +10.0pp | 84.6% |
| Q4 FY2026(指引) | 500 亿美元 ±10 亿 | 约 86% | +1.1pp | 约 86% |
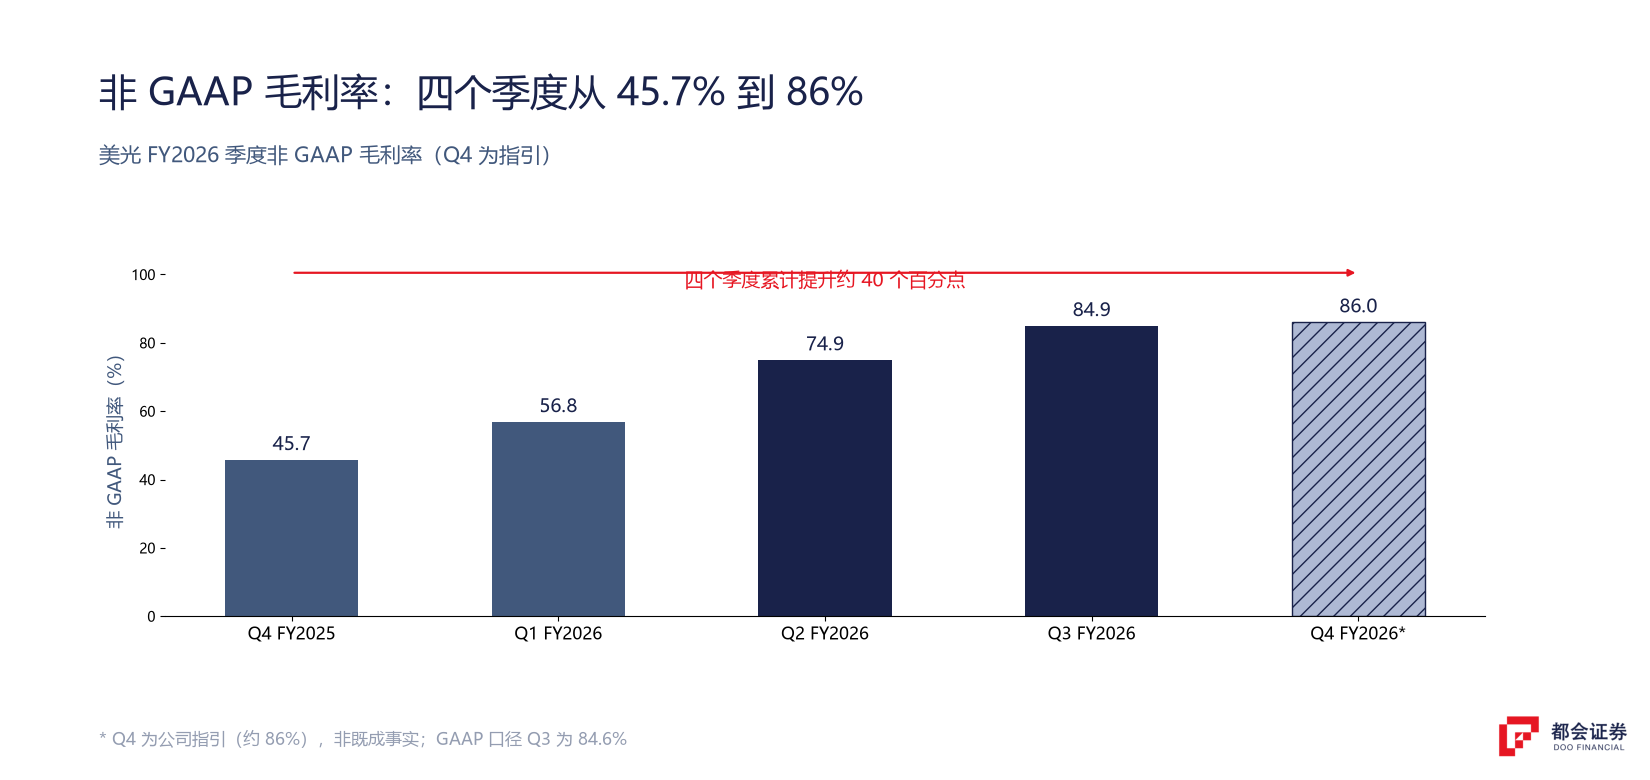
四个季度累计提升约 40 个百分点。按管理层电话会的定性表述、产品组合占比与 ASP 趋势推算,各驱动因素的贡献大致是:
- DRAM ASP 暴涨,贡献约 20–25 个百分点。这是最大的单一驱动。路径是:AI 需求 → HBM 贸易比上升 → 标准 DRAM 晶圆被挤压 → 供应紧张 → 价格全面上涨。Q2、Q3 的 DRAM ASP 环比各涨约 60%,对毛利率的边际贡献合计约 15–18 个百分点。
- NAND ASP 暴涨,贡献约 8–10 个百分点。逻辑一脉相承:部分 NAND 晶圆产能被重新分配给 DRAM,NAND 供应收紧,SSD 价格跟着涨。
- 高毛利产品占比提升,贡献约 5–7 个百分点。HBM 和数据中心 SSD 的毛利率显著高于平均,占比上升直接拉高整体毛利率。
- 制造成本下降,贡献约 2–3 个百分点。公司在 10-K 里把 DRAM 和 NAND 的毛利改善都部分归因于制造工艺改进带来的成本降低。
需要说明的是,以上是按公开信息做的方向性估算,不是公司披露的拆分;实际贡献受产品组合、成本结构与产能利用率的交互影响。
Q4 指引毛利率约 86%,环比只提升约 1 个百分点。这种边际递减反映了基数抬高、ASP 涨幅趋缓以及新产能爬坡成本的压力。但 SCA 里约 40% 的收入设有固定价格或价格上限,底价对毛利率形成了支撑。
按 Q1–Q3 实际值加 Q4 指引中值计算,FY2026 全年营收约 1,289.6 亿美元,非 GAAP 毛利率约 80.5%,毛利润约 1,038 亿美元——相比 FY2025 的约 40% 大致翻倍。
隐忧:周期顶部、客户集中与地缘政治
这套 AI 叙事并不是没有风险。
供给端。HBM4 12-high 的爬坡速度虽然是 HBM3E 的两倍,但先进封装(TSV 堆叠)的良率波动可能影响出货节奏。爱达荷与纽约的新工厂 DRAM 产能计划分别于 2027 下半年和更晚投产,时间表存在执行风险。如果 DRAM 需求持续超预期,更多 NAND 晶圆可能被重新分配,反而让 NAND 供应更紧。
需求端。美光在 10-Q 里披露,FY2026 前九个月单一客户贡献约 10% 营收(FY2026 第一财季为 17%,上半年为 13%)——客户集中度不低。如果超大规模云厂商的 AI 资本开支增速放缓,DRAM 和 NAND 需求可能快速调整。
价格端。FY2026 前九个月 DRAM ASP 累计涨幅约 140%。这种幅度的涨价在历史上罕见,本身就会吸引新产能进入。公司在风险披露里也写明:过去五个财年,DRAM 年度 ASP 的波动区间从上涨 40% 多到下跌 40% 多。存储行业周期性强,当前处在上行周期的偏高位。
地缘政治。美光已退出中国服务器市场,这块业务此前约贡献 34 亿美元年营收;出口管制也可能限制先进 HBM 产品向特定市场销售。
想弄清自己手里的标的属于估值受压还是盈利兑现,可以按研究一家美股公司先别急着看涨跌里的顺序过一遍。美光这家公司本身,可以看美光科技(MU)是什么公司;想动手交易,操作链在美光为什么热门与美光股票怎么买里。
常见问题
主要是价格驱动。AI 需求推高 HBM 出货,HBM 占用的晶圆产能挤压了标准 DRAM 供给,带动 DRAM 与 NAND 全面涨价;叠加 HBM、数据中心 SSD 等高毛利产品占比提升和制造成本下降,非 GAAP 毛利率从 FY2025 Q4 的 45.7% 升到 FY2026 Q3 的 84.9%。
美光 HBM 营收份额约 18%,但整体运营利润率约 80.4%,高于份额第一的 SK 海力士(约 76%)。原因是美光 DRAM 占比更高、HBM 有 ASP 溢价,且非 HBM DRAM 在供应紧张下有定价权;而 SK 海力士把更多产能投在 HBM 上,可用于标准 DRAM 的晶圆更少。
生产 HBM 占用的晶圆面积远高于标准 DRAM。HBM 出货增加会挤压标准 DRAM 的晶圆供给,导致普通 DRAM 也供应紧张、价格上涨——这就是文章里说的「挤占效应」。
目前供给仍偏紧,HBM 产能已订满至 2027 日历年。但价格端已经出现边际递减迹象(Q4 指引毛利率环比仅升约 1 个百分点),且新产能预计 2027 年后陆续落地。周期方向取决于供给释放与 AI 需求增速的赛跑。
HBM 贴在 GPU 封装内,带宽最高、延时最低,负责喂数据给算力;服务器 DRAM 是系统主存;数据中心 SSD 负责持久化存储大模型数据和上下文。三者处在 AI 存储层级的不同位置,不能互相替代。
存储行业的周期性、客户集中度(FY2026 前九个月单一客户约占 10% 营收)、新产能投产的时间表风险,以及地缘政治与出口管制。本文不构成投资建议。


